利用Linux内核中的空指针解引用漏洞
作者:Seth Jenkins,Project Zero
在相当长的一段时间里,空指针解引用(null-deref)漏洞曾是内核中高度可利用的漏洞类型。在内核能够无限制访问用户空间内存、且用户空间程序仍能映射零页的时代,存在许多利用空指针解引用漏洞的简单技术。然而,随着现代漏洞缓解措施(如SMEP和SMAP)的引入,以及mmap_min_addr阻止非特权程序映射低地址,空指针解引用漏洞在现代内核版本中通常不被视为安全问题。这篇博客文章提供了一种利用技术,表明将这些漏洞普遍视为无害往往会导致对其安全相关性的错误评估。
内核Oops概述
目前,当Linux内核在进程上下文中触发空指针解引用时,它会生成一个oops,这与内核恐慌(panic)不同。当内核确定没有安全的方式继续执行时,会发生恐慌,因此必须停止所有执行。然而,内核在发生oops时不会停止所有执行——相反,内核会尽力恢复并继续执行。对于任务(task)而言,这涉及丢弃现有的内核栈并直接调用make_task_dead,后者会调用do_exit。内核还会在dmesg中发布一个"崩溃"日志和内核回溯,描述oops发生时内核的状态。当明显发生内存损坏时,这似乎是一个奇怪的选择——然而其意图是让内核漏洞更容易被检测和记录,遵循一个正常工作的系统比死掉的系统更容易调试的理念。
oops恢复路径的一个不幸副作用是,内核无法执行在典型系统调用错误恢复路径上通常会执行的任何相关清理工作。这意味着在oops发生时锁定的任何锁将保持锁定状态,任何引用计数(refcount)将保持被占用状态,任何临时分配的内存将保持分配状态,等等。然而,触发oops的进程、其关联的内核栈、任务结构体(task struct)及派生成员等可以被释放,并且通常会被释放,这意味着根据oops的具体情况,可能实际上没有内存泄漏。这在后续的利用中变得尤为重要。
引用计数管理不当概述
引用计数管理不当是一个相当知名且可利用的问题。当软件错误地减少引用计数时,可能导致经典的释放后使用(UAF)原语。软件错误地不减少引用计数(泄漏引用)的情况也常常可利用。如果攻击者能导致引用计数被重复错误地增加,那么经过足够多的尝试后,引用计数可能会溢出,此时软件不再对对象上有多少引用计数有任何合理的概念。在这种情况下,攻击者有可能在溢出后通过增加和减少引用计数使其归零来销毁对象,同时仍持有对相关内存的可访问引用。32位引用计数特别容易受到这种溢出攻击。然而,重要的是引用计数的每次增加分配很少或不分配物理内存。即使每次只分配一个字节,如果需要执行2^32次,成本也相当高昂。
空指针解引用漏洞示例
当内核oops意外终止一个任务时,该任务持有的任何引用计数将保持被占用状态,即使任务退出时与任务关联的所有内存可能被释放。让我们看一个例子——这是我最近偶然发现的另一个无关漏洞:
static int show_smaps_rollup(struct seq_file *m, void *v)
{
    struct proc_maps_private *priv = m->private;
    struct mem_size_stats mss;
    struct mm_struct *mm;
    struct vm_area_struct *vma;
    unsigned long last_vma_end = 0;
    int ret = 0;

    priv->task = get_proc_task(priv->inode); //获取任务引用
    if (!priv->task)
        return -ESRCH;

    mm = priv->mm; //没有VMA时,mm->mmap为NULL
    if (!mm || !mmget_not_zero(mm)) { //获取mm引用
        ret = -ESRCH;
        goto out_put_task;
    }

    memset(&mss, 0, sizeof(mss));

    ret = mmap_read_lock_killable(mm); //获取mmap读锁
    if (ret)
        goto out_put_mm;

    hold_task_mempolicy(priv);

    for (vma = priv->mm->mmap; vma; vma = vma->vm_next) {
        smap_gather_stats(vma, &mss);
        last_vma_end = vma->vm_end;
    }

    show_vma_header_prefix(m, priv->mm->mmap->vm_start,last_vma_end, 0, 0, 0, 0); //此处解引用mmap导致内核oops

    seq_pad(m, ' ');
    seq_puts(m, "[rollup]\n");
    __show_smap(m, &mss, true);

    release_task_mempolicy(priv);
    mmap_read_unlock(mm);

out_put_mm:
    mmput(mm);

out_put_task:
    put_task_struct(priv->task);
    priv->task = NULL;

    return ret;
}
这个文件的目的只是打印相应进程的一组内存使用统计信息。尽管如此,这个漏洞报告揭示了该函数中一个经典且原本无害的空指针解引用漏洞。对于一个根本没有映射任何VMA的任务,其mm_struct的mmap成员将等于NULL。因此,priv->mm->mmap->vm_start访问会导致空指针解引用,从而引发内核oops。这个漏洞可以通过简单地读取没有VMA的任务的/proc/[pid]/smaps_rollup来触发(该任务本身可以通过ptrace稳定创建):
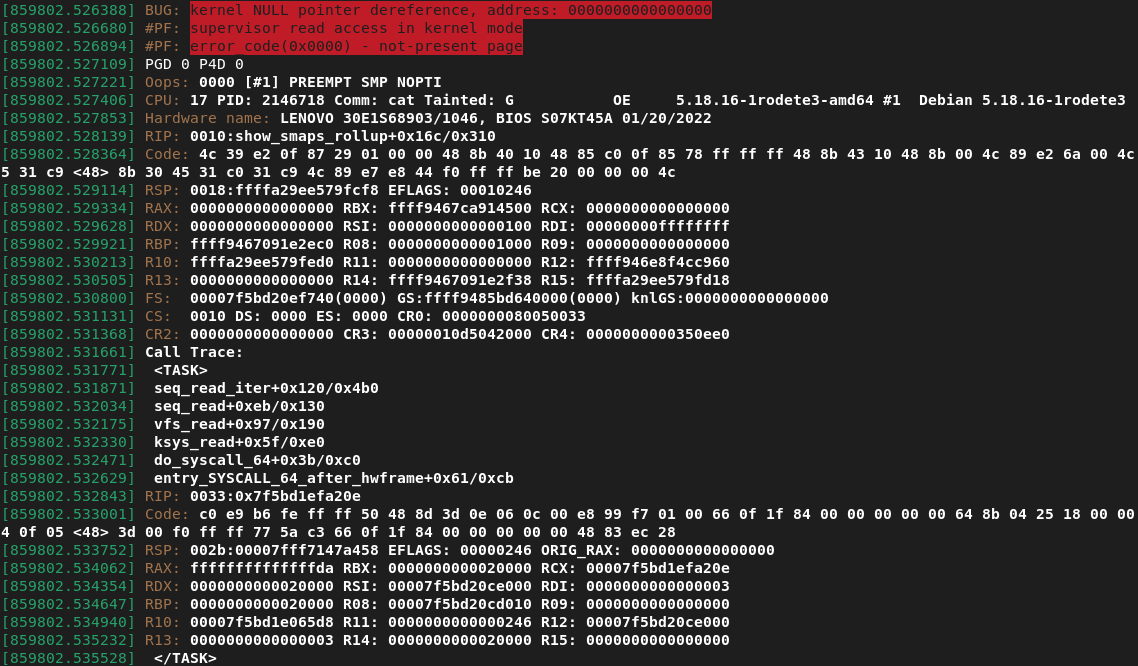
这个内核oops将意味着以下事件发生:
- 如果fdget获取了引用计数,相关的struct file将泄漏一个引用计数(我们稍后会尝试确保这种情况不发生)
- struct file内的相关seq_file有一个将永远被锁定的互斥锁(任何未来的读取/写入/lseek等操作将永远挂起)
- 与smaps_rollup文件关联的任务结构体将泄漏一个引用计数
- 与任务关联的mm_struct的mm_users引用计数将被泄漏
- mm_struct的mmap锁将被永久读锁定(任何未来的写锁定尝试将永远挂起)
这些条件中的每一个都是导致错误行为的意外副作用,但并非所有这些行为都对攻击者有用。事件2和5的永久锁定只会使利用更加困难。条件1不可利用,因为如果不获取一个永远不会解锁的互斥锁,我们无法再次泄漏struct file的引用计数。条件3不可利用,因为任务结构体使用安全的饱和内核refcount_t,防止了溢出条件。这就剩下条件4。
mm_users引用计数仍然使用不安全的溢出原子类型atomic_t,并且由于我们可以无限次地获取读锁,相关的mmap_read_lock不会阻止我们再次增加引用计数。为了重复泄漏这个引用计数,我们需要避免几个重要的障碍:
- 我们不能从具有空VMA列表的任务本身调用这个系统调用——换句话说,我们不能从/proc/self/smaps_rollup调用read。这样的进程由于没有映射虚拟内存,很难进行重复的系统调用。我们通过从另一个进程读取smaps_rollup来避免这个问题。
- 我们必须每次都重新打开smaps_rollup文件,因为我们在已经触发oops的smaps_rollup实例上执行的任何未来读取都会在本地seq_file互斥锁上死锁,该锁被永久锁定。我们还需要在生成oops后销毁生成的struct file(通过close),以防止不可持续的内存使用。
- 如果我们每次通过相同的pid访问mm,我们会在溢出mm_users引用计数之前遇到任务结构体的最大引用计数限制。因此,我们需要创建两个共享相同mm的独立任务,并在两个任务之间平衡我们生成的oops,使任务引用计数的增长速度是mm_users引用计数的一半。我们通过clone标志CLONE_VM来实现这一点。
- 我们必须避免从具有共享文件描述符表的任务中打开/读取smaps_rollup文件,否则struct file本身将泄漏引用计数。这并不困难,只需不要从多线程进程读取文件即可。
我们最终的引用计数泄漏溢出策略如下:
- 进程A fork进程B
- 进程B发出PTRACE_TRACEME,以便在从munmap返回时发生段错误时不会消失(而是会进入跟踪停止状态)
- 进程B使用CLONE_VM | CLONE_PTRACE克隆另一个进程C
- 进程B munmap其整个虚拟内存地址空间——这也取消映射了进程C的虚拟内存地址空间
- 进程A fork新的子进程D和E,它们将分别访问(B|C)的smaps_rollup文件
- (D|E)打开(B|C)的smaps_rollup文件并执行读取,这将导致oops,使(D|E)死亡。每次oops都会导致mm_users引用计数泄漏/增加一次
- 进程A回到步骤5,重复约2^32次
上述策略可以重新架构以并行运行(跨进程而非线程,因为障碍4)并提高性能。在将内核日志打印到串行控制台的服务器设置上,生成2^32个内核oops需要超过2年时间。然而,在使用图形界面的普通Kali Linux机器上,一个演示性的概念验证仅需约8天即可完成!执行完成后,mm_users引用计数将溢出并被设置为零,即使这个mm当前正被多个进程使用,并且仍然可以通过proc文件系统引用。
利用
一旦mm_users引用计数被设置为零,触发未定义行为和内存损坏应该相当容易。通过触发mmget和mmput(我们可以通过再次打开smaps_rollup文件轻松实现),我们应该能够释放整个mm并导致UAF条件:
static inline void __mmput(struct mm_struct *mm)
{
    VM_BUG_ON(atomic_read(&mm->mm_users));

    uprobe_clear_state(mm);
    exit_aio(mm);
    ksm_exit(mm);
    khugepaged_exit(mm);
    exit_mmap(mm);
    mm_put_huge_zero_page(mm);
    set_mm_exe_file(mm, NULL);
    if (!list_empty(&mm->mmlist)) {
        spin_lock(&mmlist_lock);
        list_del(&mm->mmlist);
        spin_unlock(&mmlist_lock);
    }
    if (mm->binfmt)
        module_put(mm->binfmt->module);
    lru_gen_del_mm(mm);
    mmdrop(mm);
}
不幸的是,自64591e8605("mm: protect free_pgtables with mmap_lock write lock in exit_mmap")以来,exit_mmap无条件地以写模式获取mmap锁。由于这个mm的mmap_lock被永久读锁定了多次,任何对__mmput的调用都将在exit_mmap内部表现为永久死锁。
然而,在调用永久死锁之前,它将调用其他几个函数:
- uprobe_clear_state
- exit_aio
- ksm_exit
- khugepaged_exit
此外,我们可以通过让多个任务中的每一个触发该mm上的mmget/mmput,从而同时对该mm调用__mmput,产生不规则的竞争条件。在正常执行下,不应该可能在同一mm上触发多个__mmput调用(更不用说并发的了),因为__mmput应该只在最后一个也是唯一一个将引用计数设置为零的递减操作时被调用。然而,在引用计数溢出后,对仍然被引用的mm的所有mmget/mmput操作都将触发__mmput。这是因为每个将引用计数递减到零的mmput(尽管相应的mmget是引用计数最初大于零的原因)都认为它独自负责释放相关的mm。
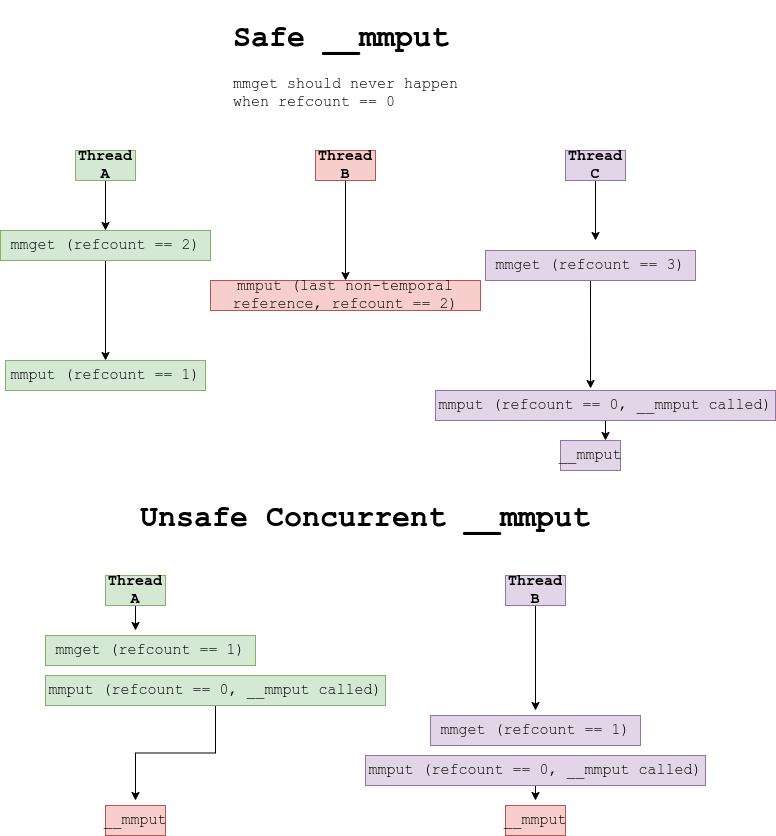
这种竞态的__mmput原语也延伸到其被调用函数。exit_aio是利用这一点的好候选:
void exit_aio(struct mm_struct *mm)
{
    struct kioctx_table *table = rcu_dereference_raw(mm->ioctx_table);
    struct ctx_rq_wait wait;
    int i, skipped;

    if (!table)
        return;

    atomic_set(&wait.count, table->nr);
    init_completion(&wait.comp);

    skipped = 0;
    for (i = 0; i < table->nr; ++i) {
        struct kioctx *ctx =
            rcu_dereference_protected(table->table[i], true);
        if (!ctx) {
            skipped++;
            continue;
        }
        ctx->mmap_size = 0;
        kill_ioctx(mm, ctx, &wait);
    }

    if (!atomic_sub_and_test(skipped, &wait.count)) {
        /* Wait until all IO for the context are done. */
        wait_for_completion(&wait.comp);
    }

    RCU_INIT_POINTER(mm->ioctx_table, NULL);
    kfree(table);
}
虽然被调用函数kill_ioctx的编写方式可以防止并发执行导致内存损坏(aio的契约部分允许以并发方式调用kill_ioctx),但exit_aio本身没有这样的保证。因此,对同一mm结构体的两个并发exit_aio调用可能导致mm->ioctx_table对象的双重释放,该对象在函数开始时获取,只在函数最后才被释放。通过创建许多aio上下文来减慢exit_aio内部上下文释放循环的速度,可以显著扩大这个竞争窗口。成功利用将触发以下内核BUG,表明发生了双重释放:
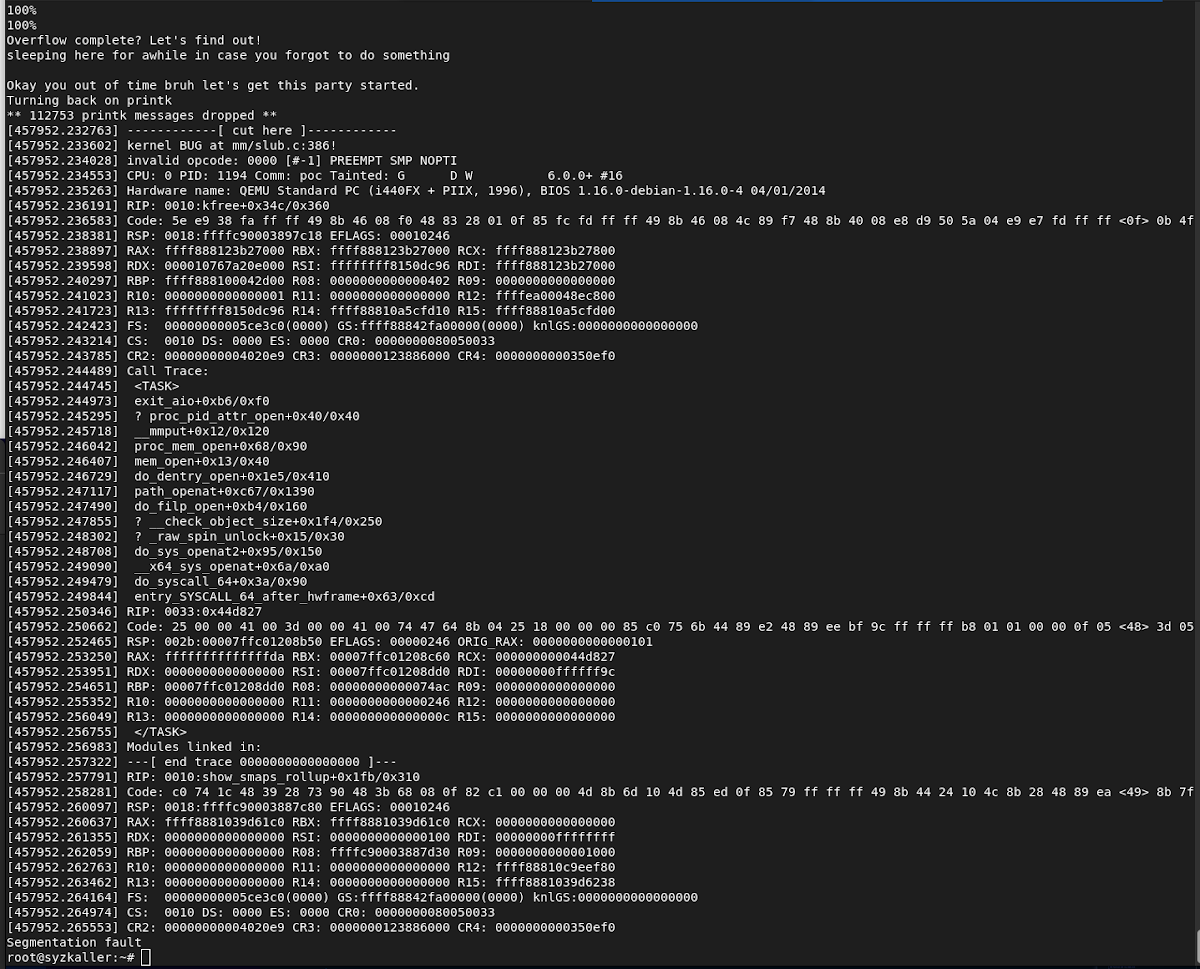
请注意,由于这个exit_aio路径是从__mmput触发的,触发这个竞争将产生至少两个永久死锁的进程,当这些进程稍后尝试获取mmap写锁时。然而,从利用的角度来看,这是无关紧要的,因为内存损坏原语已经在死锁发生之前发生。利用结果原语可能涉及在两次释放mm->ioctx_table对象之间进行回收分配竞争,然后利用回收分配产生的UAF条件。这无疑是可能的,尽管我没有将其完全实现为一个完整的PoC。
结论
虽然空指针解引用漏洞本身已在2022年10月修复,但更重要的修复是引入了oops限制,如果发生太多oops,会导致内核恐慌。虽然这个补丁已经上游,但如果我们希望在未来避免将此类空指针解引用漏洞视为完全的安全问题,那么分发版内核继承这个oops限制并将其向后移植到LTS版本中是非常重要的。即使在最佳情况下,安全研究人员仔细评估未来发现的类似"无害"漏洞的副作用,并确保内核oops导致的内核代码执行突然停止不会导致其他安全相关的原语,仍然是非常有益的。