利用CVE-2022-42703漏洞 - 重拾栈攻击技术
Seth Jenkins,Project Zero
这篇博客文章详细介绍了CVE-2022-42703(P0 issue 2351 - 已于2022年9月5日修复)的利用方法。这是Jann Horn在Linux内核内存管理(MM)子系统中发现的一个漏洞,会导致struct anon_vma的use-after-free。由于这个漏洞非常复杂(我确实很难完全理解!),后续的博客文章将完整描述这个漏洞。目前,issue tracker条目、这篇解释anon_vma是什么的LWN文章以及引入该漏洞的提交都是获取额外背景信息的绝佳资源。
场景设定
成功触发底层漏洞会导致folio->mapping指向一个已释放的anon_vma对象。随后调用madvise(..., MADV_PAGEOUT)可用于在folio_lock_anon_vma_read()中重复触发对已释放anon_vma的访问:
struct anon_vma *folio_lock_anon_vma_read(struct folio *folio,
                                          struct rmap_walk_control *rwc)
{
    struct anon_vma *anon_vma = NULL;
    struct anon_vma *root_anon_vma;
    unsigned long anon_mapping;

    rcu_read_lock();
    anon_mapping = (unsigned long)READ_ONCE(folio->mapping);
    if ((anon_mapping & PAGE_MAPPING_FLAGS) != PAGE_MAPPING_ANON)
        goto out;
    if (!folio_mapped(folio))
        goto out;

    // anon_vma是悬垂指针
    anon_vma = (struct anon_vma *) (anon_mapping - PAGE_MAPPING_ANON);
    // root_anon_vma是从悬垂指针读取的
    root_anon_vma = READ_ONCE(anon_vma->root);
    if (down_read_trylock(&root_anon_vma->rwsem)) {
        [...]
        if (!folio_mapped(folio)) { // false
            [...]
        }
        goto out;
    }

    if (rwc && rwc->try_lock) { // true
        anon_vma = NULL;
        rwc->contended = true;
        goto out;
    }
    [...]
out:
    rcu_read_unlock();
    return anon_vma; // 返回悬垂指针
}
一种潜在的利用技术是让函数返回悬垂的anon_vma指针,并尝试让后续操作执行有用的操作。相反,我们选择使用函数内的down_read_trylock()调用来破坏选定地址的内存,如果我们能控制从已释放anon_vma读取的root_anon_vma指针,就可以做到这一点。
控制root_anon_vma指针意味着用攻击者控制的内存重新分配已释放的anon_vma。struct anon_vma结构是从它们自己的kmalloc缓存中分配的,这意味着我们不能简单地释放一个anon_vma并用不同的对象重新分配它。相反,我们采用与此处记录的非常相似的策略,使相关的anon_vma slab页面返回到内核页面分配器。通过释放slab页面上的所有anon_vma对象,然后刷新percpu slab页面部分空闲列表,我们可以使先前与anon_vma关联的虚拟内存返回到页面分配器。然后我们喷洒pipe缓冲区,以便用攻击者控制的内存重新分配已释放的anon_vma。
至此,我们已经讨论了如何将use-after-free转换为对攻击者控制指针的down_read_trylock()调用。down_read_trylock()的实现如下:
struct rw_semaphore {
    atomic_long_t count;
    atomic_long_t owner;
    struct optimistic_spin_queue osq; /* spinner MCS lock */
    raw_spinlock_t wait_lock;
    struct list_head wait_list;
};

...
static inline int __down_read_trylock(struct rw_semaphore *sem)
{
    long tmp;

    DEBUG_RWSEMS_WARN_ON(sem->magic != sem, sem);

    tmp = atomic_long_read(&sem->count);
    while (!(tmp & RWSEM_READ_FAILED_MASK)) {
        if (atomic_long_try_cmpxchg_acquire(&sem->count, &tmp,
                                            tmp + RWSEM_READER_BIAS)) {
            rwsem_set_reader_owned(sem);
            return 1;
        }
    }
    return 0;
}
在unicorn中模拟down_read_trylock()以确定它在给定不同sem->count值时的行为是很有帮助的。假设此代码在惰性且不变的内存上操作,如果最低3位和最高位都未设置,它将使sem->count增加0x100。这意味着很难修改内核指针,并且我们无法修改任何非8字节对齐的值(因为它们会设置底部三位中的一位或多位)。此外,这个信号量稍后会被解锁,导致我们执行的任何写入在不久的将来被恢复。而且,此时我们还没有确定的策略来确定KASLR偏移量,也没有弄清楚我们可能想要用新获得的原语覆盖的任何对象的地址。事实证明,无论内核当前设置了何种随机化,即使给定如此受限的任意写入原语,也有一种直接的策略可以利用此漏洞。
栈破坏...
在x86-64 Linux上,当CPU执行某些中断和异常时,它将交换到映射到静态且非随机化虚拟地址的相应栈,不同类型的异常使用不同的栈。关于这些栈及其父结构cpu_entry_area的简要文档可以在此处找到。这些栈最常用于从用户态进入内核时,但也用于内核模式中发生的异常。我们最近看到KCTF参赛者利用非随机化的cpu_entry_area栈,即使在存在SMAP和KASLR的情况下,也能在内核可访问内存中访问已知虚拟地址的数据。你也可以使用这些栈在已知的内核虚拟地址处伪造攻击者控制的数据。这是因为当由于这些异常之一从用户态切换到内核模式时,攻击者任务的通用寄存器内容被直接推送到此栈上。当内核本身生成中断栈表异常并交换到异常栈时也会发生这种情况——除了在这种情况下,推送的是内核GPR。这些推送的寄存器稍后在处理异常后用于恢复内核状态。在用户态触发异常的情况下,寄存器内容从任务栈恢复。
IST异常的一个例子是DB异常,攻击者可以通过硬件断点触发,其相关寄存器在此处描述。硬件断点可以由多种不同的内存访问类型触发,即读取、写入和指令获取。这些硬件断点可以使用ptrace(2)设置,并在任务上下文(如系统调用期间)的内核模式执行期间保留。这意味着攻击者设置的硬件断点可能在内核模式中被触发,例如在copy_to/from_user调用期间。产生的异常将通过上述非随机化的异常栈保存和恢复内核上下文,而该内核上下文是我们任意写入原语的绝佳目标。
copy_to/from_user在处理硬件断点时正在使用的任何寄存器都可以通过使用我们的任意写入原语覆盖它们在异常栈上的保存值来破坏。在这种情况下,copy_user调用的大小是直观的目标。大小值始终存储在rcx寄存器中,每次触发硬件断点时,它都将保存在相同的虚拟地址。用我们的任意写入原语破坏这个保存的寄存器后,内核一旦返回到copy_to/from_user,将从异常栈恢复rcx。由于rcx定义了copy_user应复制的字节数,这种破坏将导致内核在用户态和内核之间非法复制过多字节。
...导致栈破坏
攻击策略如下:
- 从进程X fork进程Y。
- 进程X ptrace进程Y,然后在进程Y的已知虚拟地址[addr]处设置硬件断点。
- 进程Y进行大量uname(2)调用,该调用从内核栈缓冲区调用copy_to_user到[addr]。这导致内核不断触发硬件监视点并进入DB异常处理程序,使用DB异常栈保存和恢复copy_to_user状态。
- 同时在DB异常栈保存的rcx值的已知位置进行多次任意写入,该值是进程Y的copy_to_user的保存长度。
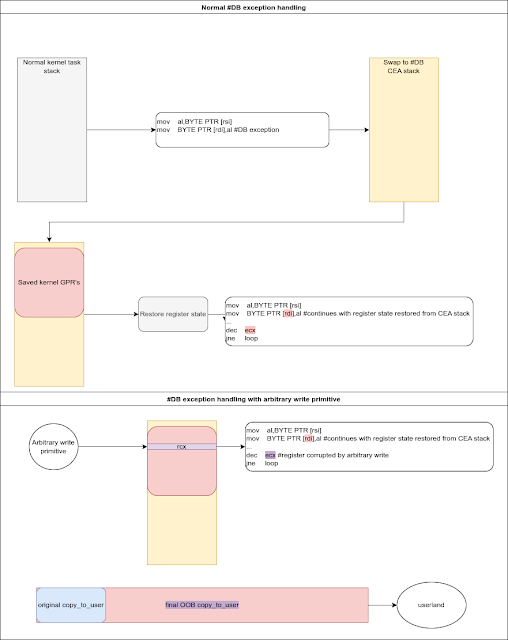
DB异常栈很少使用,因此不太可能在我们任意写入原语泛滥时通过虚假的DB异常破坏任何意外的内核状态。该技术也存在竞争条件,但错过竞争只是意味着破坏陈旧的栈数据。在这种情况下,我们只需重试。根据我的经验,成功赢得竞争很少需要超过几秒钟。
成功破坏长度值后,内核会将当前任务的大部分栈复制回用户态,包括任务本地栈cookie和返回地址。随后我们可以反转我们的技术,转而攻击copy_from_user调用。我们不是从内核任务栈复制过多字节到用户态,而是诱使内核从用户态复制过多字节到内核任务栈!我们再次使用一个系统调用prctl(2),它执行copy_from_user调用到内核栈缓冲区。现在通过破坏长度值,我们在此函数中生成了栈缓冲区溢出条件,而之前不存在这种情况。由于我们已经泄露了栈cookie和KASLR偏移,绕过这两种缓解措施并覆盖返回地址变得非常简单。
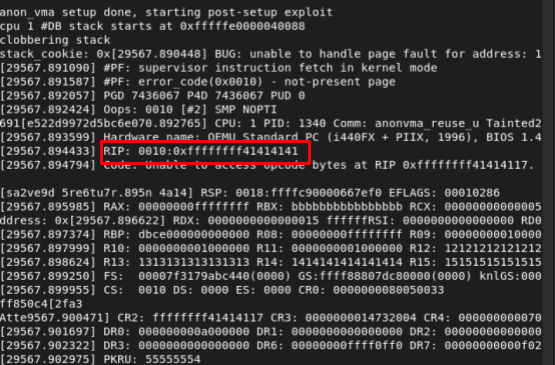
为内核完成ROP链留给读者作为练习。
使用prefetch获取KASLR偏移
在向Linux内核安全团队报告此漏洞时,我们的建议是开始随机化percpu cpu_entry_area(CEA)的位置,从而随机化相关的异常和系统调用入口栈。这对远程攻击者是一种有效的缓解措施,但不足以防止本地攻击者利用。6年前,Daniel Gruss等人发现了一种新的更可靠的技术来利用x86 CPU中的TLB时序侧信道。他们的结果表明,根据要预取的请求虚拟地址是否映射,在用户模式下执行的prefetch指令在统计上具有显著不同的延迟,即使该虚拟地址仅在内核模式下映射。kPTI有助于缓解这种侧信道,然而,现在大多数现代CPU都对Meltdown(kPTI专门设计来解决的问题)具有内在保护,因此kPTI(具有显著的性能影响)在现代微架构上被禁用。这一决定意味着再次可以利用prefetch侧信道不仅击败KASLR,还能击败CPU入口区域随机化缓解措施,从而保留了CEA栈破坏利用技术在现代X86 CPU上的可行性。
开源领域中可用的这种prefetch KASLR绕过技术的快速可靠示例出人意料地少,因此我决定编写一个。
实现
有效实现此技术的核心在于在执行prefetch前后串行读取处理器的时间戳计数器。Daniel Gruss提供了高效且开源的代码来做到这一点。我做的唯一编辑(按照Jann Horn的建议)是改用lfence而不是cpuid作为串行化指令,因为cpuid在VM环境中被模拟。在实践中还发现,为了观察到侧信道效应,无需执行任何缓存刷新例程。简单地计时每次prefetch尝试就足够了。
为所有512个可能的KASLR槽生成prefetch计时会产生大量需要分析的模糊数据。为了最小化噪声,对每个测试地址进行多次采样,并使用该组样本中的最小值作为该地址的代表值。在主要进行此测试的Tiger Lake CPU上,每个槽最多只需要16个样本就能产生极其可靠的结果。低分辨率的最小prefetch时间槽识别缩小了搜索区域,同时避免了高分辨率边缘检测代码的误报,该代码找到prefetch运行时间急剧下降的精确地址。这项工作的结果是PoC,可以在我的本地机器上以99.999%的准确率(在VM中为95%的准确率)正确识别KASLR偏移,同时运行速度比通过kallsyms grep内核基地址更快:
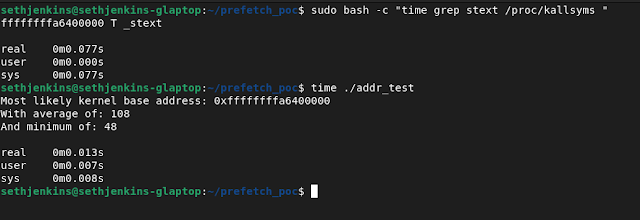
这段prefetch代码确实可以找到Peter Ziljstra提出的补丁中随机化CEA区域的位置。然而,实现这一点的过程产生的代码展示了另一个极其重要的问题——在x86上,KASLR对本地攻击者已全面受损,过去几年一直如此,并且在可预见的未来仍将如此。目前没有计划解决导致此类侧信道的众多微架构问题。未来需要在这一领域开展工作,以保持KASLR的完整性,或者,也许是时候接受KASLR不再是对抗本地攻击者的有效缓解措施,并开发接受其局限性的防御代码和缓解措施。
结论
此利用展示了一种高度可靠且不可知的技术,可以使各种不受控的任意写入原语在x86平台上实现内核代码执行。虽然可以从远程上下文缓解此利用技术,但本地上下文中的攻击者可以利用已知的微架构侧信道来击败当前的缓解措施。在这一领域进行额外工作可能很有价值,以使利用更加困难,例如执行栈内随机化,使得保存状态的栈偏移在每次发生IST异常时都发生变化。然而,目前这仍然是x86 Linux上一个可行且强大的利用策略。