与时间赛跑——命中微小的内核竞争窗口
TL;DR:
如何在未启用 CONFIG_PREEMPT 的内核上,将一个微小的内核竞争窗口变得非常大:
- 利用缓存未命中(cache miss)稍微扩大竞争窗口
- 在该窗口内让一个 timerfd 到期(这将在中断处理程序中运行——即硬中断上下文)
- 确保 timerfd 触发的唤醒必须遍历由 epoll 创建的 50000 个等待队列项
让一个线程与定时器竞争,也避免了在每次竞争尝试中累积来自两个线程的时序变化——因此有了这个标题。另一方面,这也意味着你现在必须处理硬件定时器实际如何工作的问题,这本身就会引入奇怪的时序变化。
引言
我最近在 Linux 内核中发现了一个竞争条件(https://crbug.com/project-zero/2247)。(当时我正在向某人解释 CVE-2021-0920 的修复 是如何工作的——我解释了为什么 Unix GC 现在是安全的,然后感到困惑,因为我实际上无法弄清楚为什么修复后它就安全了,最终意识到它实际上并不安全。)这是一个相当狭窄的竞争窗口,所以我很好奇是否可以用少量尝试就命中它——尤其是在没有启用 CONFIG_PREEMPT 的内核上,这会使一个线程被另一个线程抢占成为可能,正如我在 LSSEU2019 上描述的那样。
这篇文章记录了我如何在普通的 Linux 桌面内核上成功命中这个竞争,如果概念验证(PoC)针对特定机器进行了调优,命中率大约在 30% 左右。不过我没有进行完整的漏洞利用,我在获取释放后使用(UAF)访问的证据后就停止了(借助一个非常大的文件描述符表和 userfaultfd,普通用户可能无法使用,具体取决于系统配置),因为这是我好奇的部分。
这也表明,如果有人投入足够的时间来编写漏洞利用程序,即使是非常小的竞争条件仍然可能是可利用的,所以如果你将非常小的竞争窗口视为不可利用或不将此类问题视为安全漏洞,请小心。
UAF 复现程序 在我们的 bugtracker 中。
漏洞
在 Unix 域套接字垃圾回收代码中(用于处理使用 SCM_RIGHTS 文件描述符传递形成的 Unix 域套接字的引用循环),内核试图通过比较文件的引用计数与正在传输的 SKB(套接字缓冲区)中的引用数,来判断它是否可以统计到某个文件的所有引用。如果它们相等,它就假设 Unix 域套接字子系统有效地拥有对该文件的独占访问权,因为它拥有所有引用。
(相同的模式也出现在文件中,作为 __fdget_pos() 中的一种优化,参见 这个 LKML 线程。)
问题是 struct file 也可以从 RCU 读端临界区引用(你无法通过查看引用计数来检测到),并且只要引用计数非零,__fget_files() 就可以通过 get_file_rcu() / get_file_rcu_many() 将这样的 RCU 引用升级为引用计数引用。例如,当这种情况发生在 dup() 系统调用中时,生成的引用随后将被安装到 FD 表中,并可供后续系统调用使用。
当垃圾收集器(GC)认为它对一个文件拥有独占访问权时,它将在该文件上执行违反正常套接字相关系统调用(如 recvmsg())中使用的锁定规则的操作——unix_stream_read_generic() 假设排队的 SKB 只能在 ->iolock 互斥锁下被移除,但 GC 在没有使用该互斥锁的情况下移除了排队的 SKB。(感谢 Xingyu Jin 向我解释这一点。)
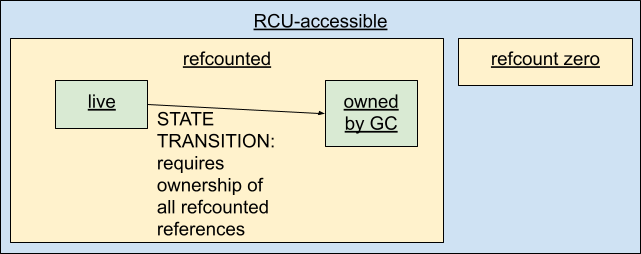
看待这个漏洞的一种方式是,GC 工作正常——这里是一个状态图,显示了 struct file 的一些可能状态,更具体的状态嵌套在不太具体的状态之下,并标记了 GC 中的状态转换:
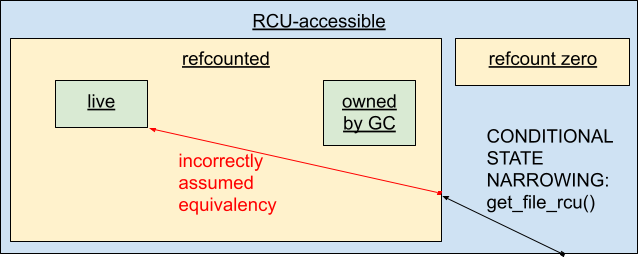
而 __fget_files() 在试图缩小 struct file 的可能状态时,对其状态做出了错误的假设——它检查 get_file_rcu() / get_file_rcu_many() 是否成功,这在一定程度上缩小了文件的状态,但还不够:
这直接导致了 漏洞是如何被修复的(还有 另一个后续补丁,但那个补丁只是试图澄清代码并挽回一些由此产生的性能损失)——修复在 __fget_files() 中添加了另一个检查,以正确缩小文件的状态,从而保证文件是存活的:
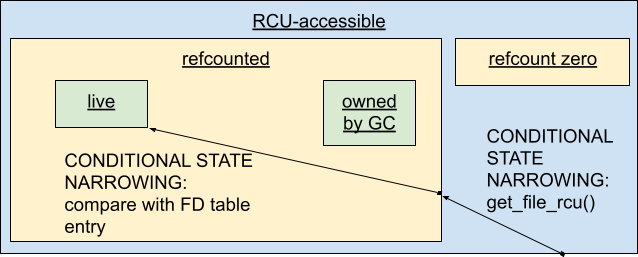
该修复通过与 FD 表项进行比较,确保只能从另一个存活引用派生出存活引用,FD 表项保证指向一个存活对象。
[旁注:这个方案类似于用于 struct page 的方案——gup_pte_range() 也使用“获取指针,增加引用计数,重新检查指针”的模式,用于从页表项中无锁地查找 struct page,同时确保在没有持有现有引用的情况下无法创建新的引用计数引用。这对于 struct page 来说非常重要,因为当 gup_pte_range() 持有对它的未计数引用时,页面可以被归还给页面分配器并重用——释放的页面仍然有它们的 struct page,因此不需要延迟页面的释放——所以如果这出了问题,你会得到一个页面 UAF。]
我最初的建议是通过改变 unix_gc() 确保独占访问的方式来解决这个问题,让它将文件的引用计数设置为零,以防止将 RCU 引用转换为引用计数引用;这样可以避免在热路径 __fget_files() 中添加任何代码,但它只会修复 unix_gc(),而不是我后来发现的 __fdget_pos() 情况,所以很可能这不是修复方式是一件好事:
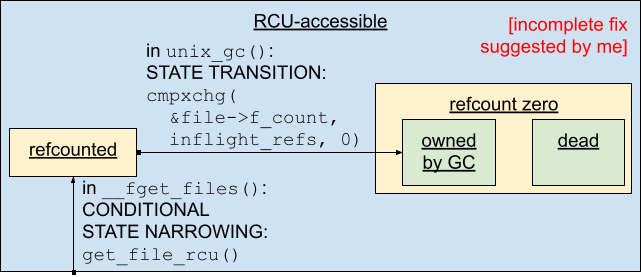
[旁注:在我最初的漏洞报告中,我写道你必须在 GC 中等待一个 RCU 宽限期,但只要 GC 确保被回收的套接字的引用计数永远不会再次变为非零,这就不必要了。]
竞争
利用这个漏洞涉及多个竞争条件,但到目前为止最难命中的一点是,我们必须在 __fget_files() 中间的小竞争窗口内(例如可以通过 dup() 到达)进行竞争操作,这个窗口位于文件描述符表查找和引用计数增加之间:
static struct file *__fget_files(struct files_struct *files, unsigned int fd,
                                 fmode_t mask, unsigned int refs)
{
        struct file *file;

        rcu_read_lock();
loop:
        file = files_lookup_fd_rcu(files, fd); // 竞争窗口开始
        if (file) {
                /* File object ref couldn't be taken.
                 * dup2() atomicity guarantee is the reason
                 * we loop to catch the new file (or NULL pointer)
                 */
                if (file->f_mode & mask)
                        file = NULL;
                else if (!get_file_rcu_many(file, refs)) // 竞争窗口结束
                        goto loop;
        }
        rcu_read_unlock();
        return file;
}
在这个竞争窗口中,文件描述符必须被关闭(以释放 FD 对文件的引用),并且 unix_gc() 运行必须通过检查文件引用计数的点("total_refs = file_count(u->sk.sk_socket->file)")。
在版本为 5.10.70-1 的 Debian 5.10.0-9-amd64 内核中,该竞争窗口如下所示:
<__fget_files+0x1e> cmp    r10,rax
<__fget_files+0x21> sbb    rax,rax
<__fget_files+0x24> mov    rdx,QWORD PTR [r11+0x8]
<__fget_files+0x28> and    eax,r8d
<__fget_files+0x2b> lea    rax,[rdx+rax*8]
<__fget_files+0x2f> mov    r12,QWORD PTR [rax] ; 竞争窗口开始
; r12 现在包含 file*
<__fget_files+0x32> test   r12,r12
<__fget_files+0x35> je     ffffffff812e3df7 <__fget_files+0x77>
<__fget_files+0x37> mov    eax,r9d
<__fget_files+0x3a> and    eax,DWORD PTR [r12+0x44] ; 加载(用于 ->f_mode)
<__fget_files+0x3f> jne    ffffffff812e3df7 <__fget_files+0x77>
<__fget_files+0x41> mov    rax,QWORD PTR [r12+0x38] ; 加载(用于 ->f_count)
<__fget_files+0x46> lea    rdx,[r12+0x38]
<__fget_files+0x4b> test   rax,rax
<__fget_files+0x4e> je     ffffffff812e3def <__fget_files+0x6f>
<__fget_files+0x50> lea    rcx,[rsi+rax*1]
<__fget_files+0x54> lock cmpxchg QWORD PTR [rdx],rcx ; 竞争窗口结束(在 cmpxchg 成功时)
如你所见,竞争窗口相当小——大约 12 条指令,假设 cmpxchg 成功。
缺失一些缓存
幸运的是,竞争窗口包含了对 struct file 的前几次内存访问;因此,通过确保 struct file 不存在于最快的 CPU 缓存中,我们可以通过内存访问所需的时间来扩大竞争窗口。标准的方法是使用驱逐模式 / 驱逐集;但我们也可以让缓存行在另一个核心上变脏(详见 Anders Fogh 的博客文章)。(实际上我不确定这在不同制造商的 CPU 核心或不同 CPU 世代上会增加多少延迟的复杂性——我只在 Intel Skylake 和 Tiger Lake 上测试了我的概念验证的不同版本。缓存一致性协议或侦听的差异可能会产生很大影响。)
对于包含 struct file 的标志和引用计数的缓存行,这可以通过在另一个 CPU 上临时增加其引用计数然后将其改回来实现,例如使用 close(dup(fd))(或者只是通过多线程进程以几乎任何方式访问 FD)。
然而,当我们试图通过 dup() 在 __fget_files() 中命中竞争时,我们不希望在命中竞争窗口之前发生任何缓存未命中——那会减慢我们的速度,并可能使我们错过竞争。为了防止这种情况发生,我们可以在尝试竞争前不久,使用一个不同的 FD 号调用 dup() 进行一次预热运行。因为我们还希望 FD 表中的相关缓存行是热的,我们应该为预热运行选择一个 FD 号,使其使用文件描述符表的同一缓存行。
一个中断
好吧,缓存未命中可能像是几十或几百纳秒左右——这更好,但还不够好。我们还能做些什么来让这一小段代码执行得更慢呢?
在 Android 上,内核通常设置 CONFIG_PREEMPT,这将允许滥用调度器以某种方式中断此代码的执行。我过去这样做的方法是给受害者线程一个低调度优先级,并将其与另一个高优先级线程一起固定到特定的 CPU 核心,高优先级线程在空管道(或 eventfd)上的 read() 系统调用上被阻塞;当数据从另一个 CPU 核心写入管道时,管道变得可读,因此高优先级线程(在管道的等待队列上注册)变得可调度,并且一个处理器间中断(IPI)被发送到受害者的 CPU 核心,强制其立即进入调度器。
这种方法的一个问题,除了依赖于 CONFIG_PREEMPT 之外,是发送 IPI 所涉及的内核代码中的任何时序变化都使得更难在正确的位置实际抢占受害者线程。
(感谢 Xen 安全团队——我想我第一次听到使用中断来扩大竞争窗口的想法可能来自他们。)
设置一个闹钟
在 Android 手机上,更好的方法不是从 IPI 触发调度器,而是从同一核心上到期的高分辨率定时器触发,尽管我没有让它工作(可能是因为我的代码在其他方面有问题)。
高分辨率定时器(hrtimers)通过许多用户空间 API 暴露。甚至 select()/pselect() 的超时也使用 hrtimer,尽管这是一个通常应用了一些松弛(slack)的 hrtimer,以便与计划稍后到期的定时器进行批处理。一个非基于 hrtimer 的 API 示例是从 Unix 域套接字(可能还有其他类型的套接字?)读取时使用的超时,可以通过 SO_RCVTIMEO 设置。
使 hrtimers 成为“高分辨率”的原因是,它们不只是等待下一个周期性时钟滴答的到来;相反,CPU 核心上下一个 hrtimer 的到期时间被编程到硬件定时器中。所以我们可以通过类似 timer_settime() 或 timerfd_settime() 的方式为未来的某个时间设置一个绝对 hrtimer,然后在精确的编程时间,硬件将引发中断!我们已经使操作系统的时序行为与竞争的另一方无关,唯一重要的是硬件!或者……嗯,差不多……
[旁注] 绝对定时器:并不完全是绝对的
所以我们选择某个我们希望被中断的绝对时间,并使用接受纳秒级绝对时间的系统调用告诉内核。然后当该定时器是下一个被调度的定时器时,操作系统将绝对时间转换为硬件定时器所基于的任何时钟基准/刻度,并将其编程到硬件中。硬件通常支持用绝对时间编程定时器——例如,在现代 X86 上(带有 X86_FEATURE_TSC_DEADLINE_TIMER),你可以简单地将一个绝对时间戳计数器(TSC)截止时间写入 MSR_IA32_TSC_DEADLINE,当达到该截止时间时,你会得到一个中断。arm64 上的情况类似,使用定时器的比较器寄存器(CVAL)。
然而,在 X86 和 arm64 上,尽管 clockevent 子系统理论上能够向 clockevent 驱动程序提供绝对时间戳(通过 ->set_next_ktime()),但驱动程序只实现了 ->set_next_event(),它接受一个相对时间作为参数。这意味着绝对时间戳必须转换为相对时间,仅仅在片刻之后又转换回绝对时间。这两个操作之间的延迟基本上被添加到定时器的到期时间中。
幸运的是,这对我来说似乎并不是真正的问题;如果是,我会尝试在计划的到期时间前不久重复调用 timerfd_settime(),以确保在最后一次对硬件定时器进行编程时,相关代码路径在缓存中是热的。(我确实在 arm64 上进行了一些实验,这似乎可能有一点帮助,但我没有真正正确地分析它。)
一个真正庞大的待办事项列表
好吧,我上面说的所有东西在启用 CONFIG_PREEMPT 的 Android 手机上会有帮助,但如果我们试图针对没有启用该选项的普通桌面/服务器内核呢?
嗯,我们仍然可以以同样的方式触发 hrtimer 中断——只是不能再使用它们立即进入调度器并抢占线程了。但是,我们可以不将中断用于抢占,而是尝试让中断处理程序运行很长时间。
Linux 有“timerfd”的概念,它是一个引用定时器的文件描述符。例如,你可以在 timerfd 上调用 read(),该操作将阻塞直到定时器到期。或者你可以使用 epoll 监控 timerfd,当定时器到期时,它将显示为可读。
当 timerfd 就绪时,所有 timerfd 的等待者(包括 epoll 监视),它们在一个链表中排队,通过 wake_up() 路径被唤醒——就像当管道变得可读时一样。因此,如果我们能让等待者列表变得非常长,中断处理程序将不得不花费大量时间遍历该列表。
对于任何连接到文件描述符的等待队列,由于 epoll,很容易添加大量条目。Epoll 将其监视绑定到特定的 FD 号,所以如果你用数百个 dup() 调用复制一个 FD,你可以使用单个 epoll 实例在该文件上安装数百个等待者。此外,单个进程可以拥有许多 epoll 实例。我使用了 500 个 epoll 实例和 100 个重复的 FD,产生了 50000 个等待队列项。
测量竞争结果
这个竞争条件的一个很好的方面是,如果你只命中了困难的竞争(在 dup() 在 FD 表查找和引用计数增加之间被抢占时关闭 FD 并运行 unix_gc()),还没有发生内存损坏,但你可以观察到 GC 错误地从受害套接字中移除了一个套接字缓冲区(SKB)。更好的是,如果竞争失败,只要受害 FD 下方没有未使用的 FD,你也可以看到它在哪个方向上失败了:
- 如果 dup() 返回 -1,则调用得太晚 / 中断发生得太早:当 __fget_files() 尝试加载时,file* 已经从 FD 表中消失。
- 如果 dup() 返回一个文件描述符:
- 如果它返回一个比受害 FD 更高的 FD,这意味着受害 FD 在 dup() 已经增加了引用计数并分配了一个新的 FD 之后才被关闭。这意味着 dup() 调用得太早 / 中断发生得太晚。
- 如果它返回旧的受害 FD 号:
- 如果在 dup() 返回的 FD 上调用 recvmsg() 返回没有数据,意味着竞争成功:GC 错误地移除了排队的 SKB。
- 如果 recvmsg() 返回数据,则中断发生在引用计数增加和分配新 FD 之间。dup() 调用得有点太早 / 中断发生得有点太晚。
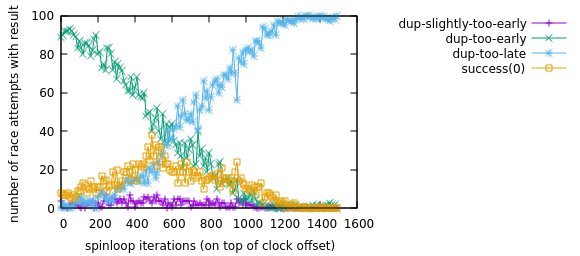
基于此,我使用具有可变迭代次数的自旋循环来反复测试不同的时序偏移,并根据时序偏移绘制了竞争尝试的结果。
结果:Debian 内核,在 Tiger Lake 上
我在一台 Tiger Lake 笔记本电脑上测试了这一点,内核与反汇编中显示的相同。请注意,X 轴上的“0”是相对于定时器编程到期时间的偏移 -300 ns。
结果:其他内核,在 Skylake 上
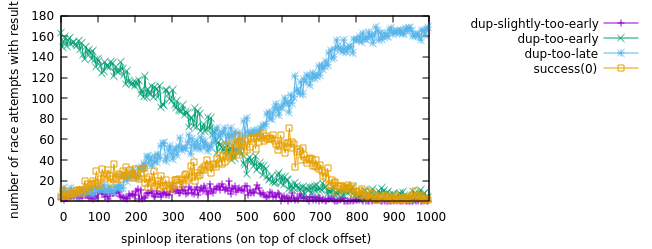
这些测量来自一台带有 Skylake CPU 的旧笔记本电脑,运行着不同的内核。这里 X 轴上的“0”是相对于定时器的偏移 -1 us。(这些时序来自运行与上面所示不同内核的系统,但我不认为这有影响。)
当然,确切的时序在不同 CPU 之间看起来不同,它们可能还基于 CPU 频率缩放而变化?但是,如果你知道正确的时序是什么(或者在尝试实际利用漏洞之前测量机器的时序),你可以以大约 30% 的成功率命中这个狭窄的竞争!
缓存未命中有多重要?
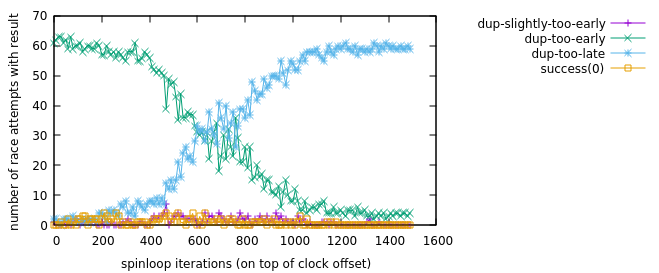
上一节显示,在正确的时序下,竞争成功的概率约为 30%——但它没有显示缓存未命中是否真的对此很重要,或者如果没有它,竞争是否仍然有效。为了验证这一点,我修补了我的测试代码,试图使文件的缓存行变热(存在于缓存中)而不是变冷(不存在于缓存中):
@@ -312,8 +312,10 @@
         }

+#if 0
         // bounce socket's file refcount over to other cpu
         pin_to(2);
         close(SYSCHK(dup(RESURRECT_FD+1-1)));
         pin_to(1);
+#endif

         //printf("setting timer\n");
@@ -352,5 +354,5 @@
         close(loop_root);
         while (ts_is_in_future(spin_stop))
-              close(SYSCHK(dup(FAKE_RESURRECT_FD)));
+              close(SYSCHK(dup(RESURRECT_FD)));
         while (ts_is_in_future(my_launch_ts)) /*spin*/;
应用该补丁后,在 Tiger Lake 笔记本电脑上的竞争结果如下所示:
但是等等,这些图表说不通啊!
如果你一直在注意,你可能已经注意到我展示的时序图表非常奇怪。如果我们每次都以完全相同的方式确定性地命中竞争,时序图应该看起来像这样(为简单起见,只看“太早”和“太晚”的情况):
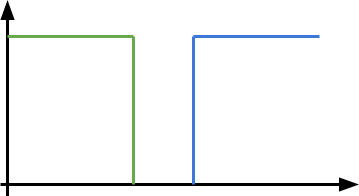
当然,也许运行之间存在一些微架构状态不同,导致时序变化——缓存状态、分支预测器状态、频率缩放,或者类似的东西——但少量未考虑的离散事件应该会在图表中添加步骤。(如果你有数学倾向,可以将其建模为理想时序图与单个离散事件的时序延迟分布的卷积结果。)对于两个未考虑的事件,可能看起来像这样:
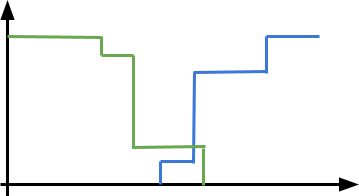
但图表显示的是更像平滑的线性过渡,像这样:
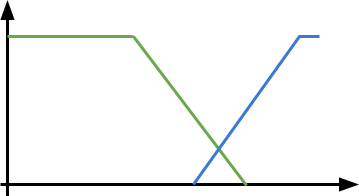
这在我看来似乎仍然存在根本性的错误。当然,如果有足够多的离散事件混合在一起,曲线最终看起来会像平滑的涂抹——但在我看来,不太可能存在如此大量且分布相对均匀的随机离散事件。当然,我们确实从自旋循环中采样时钟时获得少量的时序不准确性,但这应该被限制在该自旋循环的执行时间内,而时序涂抹对于那来说太大了。
所以看起来存在一个不是离散事件的随机性来源,而是在某个窗口内引入随机数量时序延迟的东西。所以我开始怀疑硬件定时器。内核正在使用 MSR_IA32_TSC_DEADLINE,而 Intel SDM 告诉我们,那个东西是用 TSC 值编程的,这使得定时器看起来具有非常高的粒度。但 MSR_IA32_TSC_DEADLINE 是 LAPIC 定时器的一种新模式,而旧的 LAPIC 定时器模式是以 APIC 定时器频率为单位编程的。根据 Intel SDM, Volume 3A,第 10.5.4 节“APIC Timer”,那是“处理器的总线时钟或核心晶体时钟频率(当 CPUID 叶 0x15 中枚举了 TSC/核心晶体时钟比率时)除以分频配置寄存器中指定的值”。这个频率明显低于 TSC 频率。所以也许 MSR_IA32_TSC_DEADLINE 实际上只是同一个旧 APIC 定时器的前端?
我尝试测量编程的 TSC 值与实际中断执行之间的差异(不是中断处理程序开始运行的时间,而是旧执行上下文被中断的时间——如果被中断的执行上下文只是在循环中运行 RDTSC,你可以测量到这一点);结果如下:
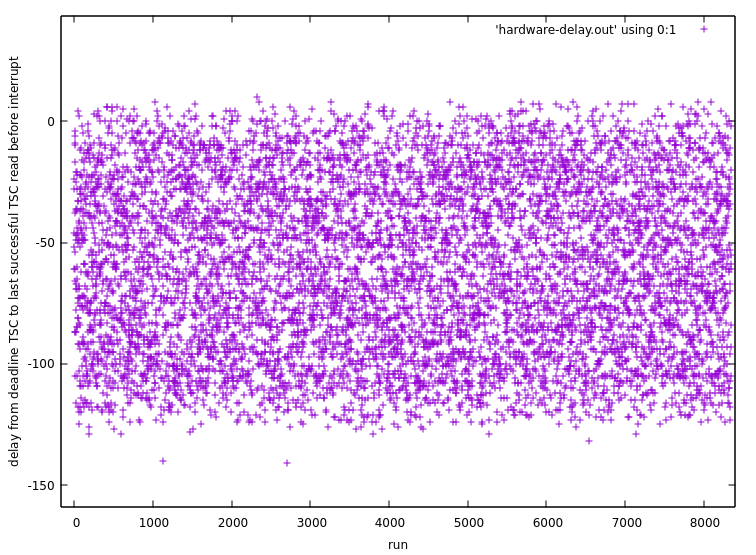
如你所见,硬件定时器的到期确实增加了一堆噪声。时序差异的大小也非常接近晶体时钟频率——这台机器上的 TSC/核心晶体时钟比率是 117。所以我尝试绘制执行被中断时的绝对 TSC 值,对 TSC/核心晶体时钟比率取模,得到了这个:
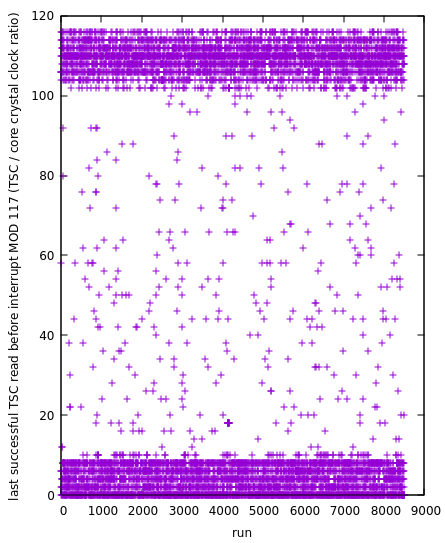
这证实了 MSR_IA32_TSC_DEADLINE(显然)是一个内部将指定的 TSC 值转换为粒度较粗的总线时钟/核心晶体时钟时间的接口,至少在某些 Intel CPU 上是这样。
但这里仍然有一些非常奇怪的地方:执行似乎被中断时的 TSC 值相对于编程的到期时间是负偏移,就好像超时被向下舍入到粒度较粗的时钟,或者类似的情况。为了更好地理解定时器中断是如何工作的,我在另一台系统(一台旧的 Haswell CPU)上使用打了补丁的内核测量了执行被中断的时间以及中断处理程序开始执行的时间相对于编程到期时间的关系(并绘制了两者之间的差异):
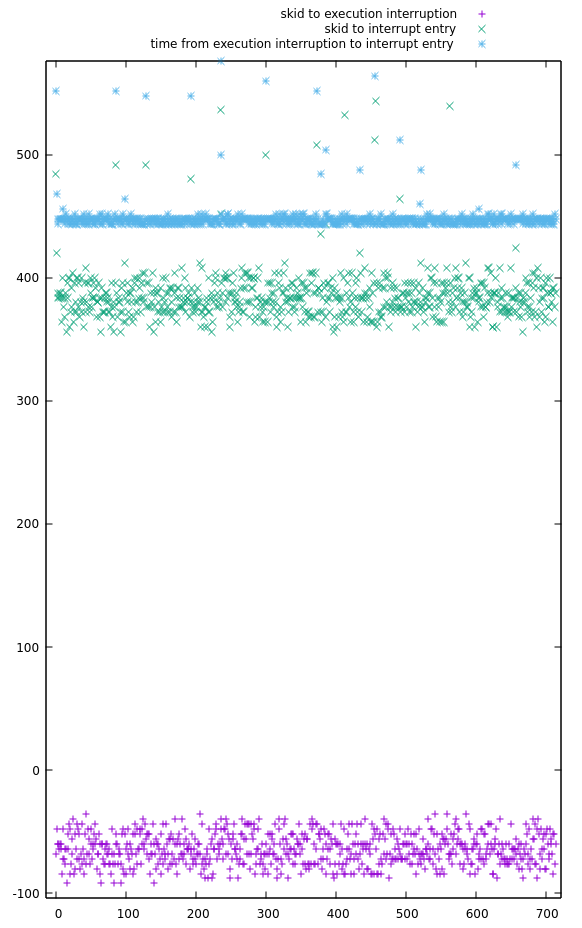
所以看起来 CPU 在编程的到期时间之前一点点开始处理定时器中断,但中断处理程序入口需要很长时间(约 450 TSC 时钟周期?),以至于当 CPU 开始执行中断处理程序时,定时器到期时间早已过去。
无论如何,对我们来说重要的是,当 CPU 由于定时器到期而中断执行时,它总是在 LAPIC 定时器边缘;而 LAPIC 定时器边缘发生在 TSC 值是 TSC/LAPIC 时钟比率的倍数时。一个没有考虑到这一点并错误地假设 MSR_IA32_TSC_DEADLINE 具有 TSC 粒度的漏洞利用程序,其时序将被涂抹一个 LAPIC 时钟周期,可能大约是 40ns。
使用现有 PoC 在正确时序下可以达到的约 30% 准确率已经不算差;但如果我们控制了定时器的怪异行为,我们能做得更好吗?
问题是我们实际上是用两个行为不同的定时器来启动竞争:一个基于在循环中调用 clock_gettime() 的定时器(它使用高分辨率 TSC 来计算时间),另一个是基于较低分辨率 LAPIC 时钟的硬件定时器。我看到两个选项来解决这个问题:
- 尝试确保第二个定时器设置在 LAPIC 时钟周期的开始——这样,第二个定时器应该有望表现得与第一个完全一样(或者有一个额外的固定偏移,但我们可以补偿)。
- 根据第二个定时器到前一个 LAPIC 时钟周期的距离,将第一个定时器的到期时间向下移动。
(这的一个烦恼是,虽然我们可以从 vDSO 使用的 vvar 映射中获取关于墙钟/单调时间如何从 TSC 计算的信息,但时钟在每个时钟滴答都会受到微小的额外校正,只要任何核心在运行,标准发行版内核(CONFIG_HZ=250)上每 4ms 发生一次。)
我尝试看看如果我考虑了这种 LAPIC 时钟舍入,并且还使用自定义内核来作弊并控制到期时间从绝对到相对再转换回来可能引入的滑移(见上文),时序图是否会看起来更好,但这仍然没有太大帮助。
(不)意外:时钟速度很重要
我早就应该想到的是,当然,时钟速度很重要。在具有 P-state 的新 Intel CPU 上,CPU 通常控制着自己的频率,并根据需要动态调整;操作系统只是提供一些提示。
Linux 有一个接口声称可以告诉你每个 CPU 核心的“当前频率”,位于 /sys/devices/system/cpu/cpufreq/policy
查看实现,结果发现那里显示的值是在 arch_freq_get_on_cpu() 及其被调用者中计算的——该值在读取文件时按需计算,结果缓存约 10 毫秒。该值被确定为上次读取和当前读取之间 MSR_IA32_APERF 和 MSR_IA32_MPERF 增量的比率。所以,如果你有一个每隔几秒轮询这些值并希望显示该时间段内平均时钟频率的工具,这可能是一个好方法;但如果你真的想要当前时钟频率,它就不太合适。
我在我的内核中 hack 了一个辅助程序,快速连续采样两个 MSR 两次,这给出了更清晰的结果。当我测量竞争成功时的时钟速度和时序偏移时,结果如下所示(仅显示两个时钟速度;Y 轴是在 X 轴指定的时钟偏移和颜色指定的频率缩放下的竞争成功次数):
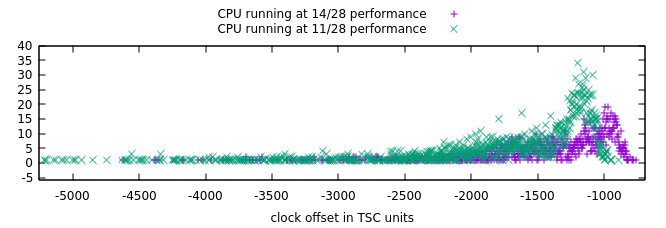
所以很明显,动态频率缩放对竞争的时序有巨大影响——我想这确实是意料之中的。
但即使考虑了所有这些,图表看起来仍然有点平滑,所以显然还有更多我遗漏的东西——好吧。我决定在这一点上停止对竞争时序的实验,因为我不想投入太多时间。(或者也许我只是因为被更新更闪亮的东西分心而停止了?)
造成 UAF
无论如何,我本可以花更多时间试图调查时序变化(可能主要是碰壁,因为执行时序的细节真的很难详细理解,要完全理解它,可能需要使用类似 Gamozo Labs 的 "Sushi Roll" 这样的东西,然后详细检查每条指令,并将观察结果与 CPU 的内部架构进行比较)。我们不要那样做,回到如何实际利用这个漏洞!
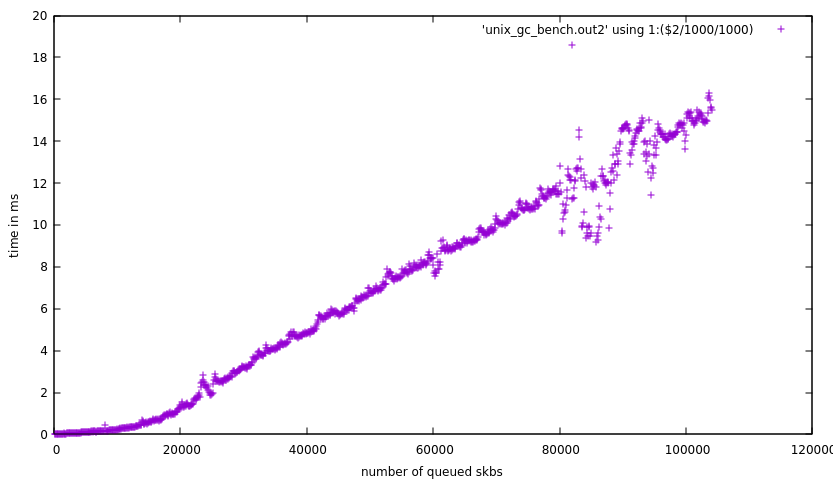
要将此漏洞转化为内存损坏,我们必须滥用 recvmsg() 路径假设接收队列上的 SKB 受套接字互斥锁保护,而 GC 实际上在没有接触套接字互斥锁的情况下从接收队列中删除 SKB。为此,在 Unix GC 运行时,我们必须启动一个 recvmsg() 调用,该调用查找受害 SKB,阻塞直到 Unix GC 释放了 SKB,然后让 recvmsg() 继续在已释放的 SKB 上操作。这相当简单——虽然它是一个竞争,但我们可以通过创建许多不直接从 FD 表引用并有许多小 SKB 排队的套接字,轻松地将 unix_gc() 减慢几毫秒——这是在我的笔记本电脑上,根据 GC 必须扫描的排队 SKB 数量,显示 Unix GC 执行时间的图表:
要将其转化为 UAF,还需要通过 unix_gc() 末尾附近的以下检查:
/* All candidates should have been detached by now. */
BUG_ON(!list_empty(&gc_candidates));
gc_candidates 是一个先前包含所有被 GC 认为不可达的套接字的列表。然后,GC 试图通过消除它们的相互引用来释放所有这些套接字。如果我们设法保留对 GC 认为将要消失的套接字之一的引用,GC 会通过 BUG_ON() 检测到这一点。
但我们实际上不需要受害 SKB 引用一个 GC 认为将要消失的套接字;在 scan_inflight() 中,GC 针对任何带有标记为 UNIX_GC_CANDIDATE 的套接字的 SKB,这意味着它只需要是 GC 扫描的候选者。因此,通过让受害 SKB 持有一个不直接从文件描述符表引用,但通过另一个套接字间接被文件描述符表引用的套接字的引用,我们可以确保 BUG_ON() 不会触发。
我用这个技巧和一些 userfaultfd 技巧扩展了 我的复现程序,以使 recv() 在正确的时机运行。如今,普通用户不一定能完全访问 userfaultfd,但由于我只是试图展示概念,并且有 userfaultfd 的替代方案(使用 FUSE 或只是慢速磁盘访问),对于这篇博文来说已经足够了。
当普通发行版内核正常运行时,UAF 复现程序的 UAF 访问实际上不会被注意到;但如果你添加内核命令行标志 slub_debug=FP(以启用 SLUB 的毒化和完整性检查),复现程序会很快崩溃两次,第一次是毒化解引用,然后是毒化覆盖检测,显示毒化的一个字节被递增:
general protection fault, probably for non-canonical address 0x6b6b6b6b6b6b6b6b: 0000 [#1] SMP NOPTI
CPU: 1 PID: 2655 Comm: hardirq_loop Not tainted 5.10.0-9-amd64 #1 Debian 5.10.70-1
[...]
RIP: 0010:unix_stream_read_generic+0x72b/0x870
Code: fe ff ff 31 ff e8 85 87 91 ff e9 a5 fe ff ff 45 01 77 44 8b 83 80 01 00 00 85 c0 0f 89 10 01 00 00 49 8b 47 38 48 85 c0 74 23 <0f> bf 00 66 85 c0 0f 85 20 01 00 00 4c 89 fe 48 8d 7c 24 58 44 89
RSP: 0018:ffffb789027f7cf0 EFLAGS: 00010202
RAX: 6b6b6b6b6b6b6b6b RBX: ffff982d1d897b40 RCX: 0000000000000000
RDX: 6a0fe1820359dce8 RSI: ffffffffa81f9ba0 RDI: 0000000000000246
RBP: ffff982d1d897ea8 R08: 0000000000000000 R09: 0000000000000000
R10: 0000000000000000 R11: ffff982d2645c900 R12: ffffb789027f7dd0
R13: ffff982d1d897c10 R14: 0000000000000001 R15: ffff982d3390e000
FS:  00007f547209d740(0000) GS:ffff98309fa40000(0000) knlGS:0000000000000000
CS:  0010 DS: 0000 ES: 0000 CR0: 0000000080050033
CR2: 00007f54722cd000 CR3: 00000001b61f4002 CR4: 0000000000770ee0
PKRU: 55555554
Call Trace:
[...]
 unix_stream_recvmsg+0x53/0x70
[...]
 __sys_recvfrom+0x166/0x180
[...]
 __x64_sys_recvfrom+0x25/0x30
 do_syscall_64+0x33/0x80
 entry_SYSCALL_64_after_hwframe+0x44/0xa9
[...]
---[ end trace 39a81eb3a52e239c ]---
=============================================================================
BUG skbuff_head_cache (Tainted: G     D          ): Poison overwritten