使用 IDA 和 TinyInst 在用户空间进行简单的 macOS 内核扩展模糊测试
作者:Ivan Fratric,Google Project Zero
最近,我参与的一个项目涉及苹果平台上的视频解码,特别是AV1解码。在支持AV1视频格式的苹果设备上(从Apple A17 iOS/M3 macOS开始),解码是在硬件中完成的。然而,尽管如此,在解码过程中,AV1格式解析的很大一部分发生在软件中,在内核内部,更具体地说是在AppleAVD内核扩展中(或者至少在macOS 14/iOS 17中曾经是这样)。由于fuzzing是我们经常使用的技术之一,如何有效地fuzz这段代码的问题不可避免地出现了。
需要指出的是,我并不是第一个研究苹果内核扩展fuzzing问题的人,因此在详细介绍我的方法之前,应该提一下这个领域的其他项目。
在Fairplay研究项目中,@pwn0rz使用自定义加载器将内核扩展加载到用户空间。一位同事尝试在当前AppleAVD扩展上运行此代码,但对他们来说并不奏效(至少不能直接使用),所以我们最终没有使用它。这里需要指出的是,我的方法也将内核代码加载到用户空间,尽管方式更轻量。
在Hexacon 2022的Cinema time!演讲中,Andrey Labunets和Nikita Tarakanov介绍了他们fuzzing AppleAVD的方法,即首先使用IDA提取反编译代码,然后重建。我过去在一些更受限的场景中使用过这种方法,但IDA反编译的代码并不完美,经常需要手动修复(例如,当IDA错误地获取函数的堆栈布局时)。
在KextFuzz项目中,Tingting Yin及其合著者通过将指针认证指令替换为跳转到收集覆盖率的trampoline来静态检测内核扩展,从而实现了部分覆盖率。
最近,Meysam Firouzi的Pishi项目就在这项研究之前发布。该项目使用Ghidra识别所有基本块,然后静态检测内核扩展代码,将每个基本块中的一条指令替换为跳转到专用trampoline的分支。trampoline记录覆盖率,执行被替换的指令,然后跳回下一条指令的地址。据报道,这可以在真实设备上运行。
考虑到这些其他项目的存在,值得说明的是,我的目标不一定是创建内核扩展fuzzing的“最佳”方法,而是对我来说最简单的方法(如果我们不计算所使用的现成工具的底层复杂性)。简而言之,我的方法(将在其他部分详细讨论)是:
- 将AppleAVD扩展或完整kernelcache加载到IDA中
- 将模块重定位到可以在用户空间中可靠分配的地址
- 使用IDA Python脚本导出原始内存
- 使用自定义加载器加载导出的字节
- 使用自定义TinyInst模块来hook和检测扩展
- 使用Jackalope进行fuzzing
所有项目代码都可以在这里找到。各种组件将在博客文章的其余部分更详细地解释。
提取内核扩展代码
通常,在macOS上,内核扩展被打包在“内核集合”文件中,这些文件充当多个扩展的容器。在首次操作系统启动时(以及每当内核扩展发生更改时),机器所需的内核扩展会被重新打包成所谓的“内核缓存”(文件系统上的kernelcache文件)。可以从这些缓存和集合中提取内核扩展,但现有的工具无法真正生成可以加载到用户空间并无问题运行的单个.dylib文件。
然而,逆向工程工具,特别是本研究中使用的IDA Pro,附带了一个令人惊讶的苹果内核缓存加载器。我没有尝试过其他逆向工程工具的比较,但如果它们具有可比性,并且有人愿意为项目做出贡献,我很乐意接受这些其他工具的导出脚本。
因此,我们可以简单地利用IDA的加载器,而不是编写自己的加载器。想法很简单:
- 我们让IDA加载我们想要的内核扩展(甚至整个kernelcache)
- 我们使用IDA重定位代码,使其位于用户空间中可映射的内存范围内(见图)
- 使用简单的IDA Python脚本,我们为每个内存段导出其起始地址、结束地址、保护标志和原始字节
- 可选地,我们还可以使用相同的脚本导出所有符号名称和相应的地址,以便稍后可以通过名称引用符号
下图显示了内核扩展的重定位。在IDA中,可以通过Edit->Segments->Rebase program…菜单访问此功能。选择新的基地址时,仅更改高位很方便,这样在需要时可以轻松地将重定位地址手动转换为原始地址,反之亦然。在下面的示例中,映像基地址从0xFFFFFE000714C470更改为0xAB0714C470。
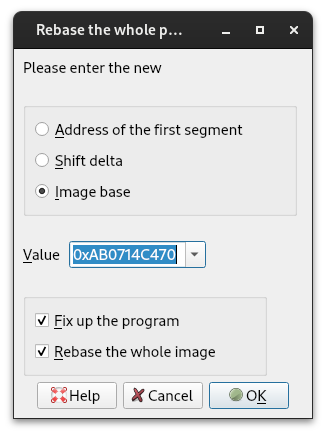
图1:重定位扩展
导出数据的IDA脚本可以在这里找到。您可以在IDA中使用以下命令运行它:
sys.path.append('/directory/containing/export/script')
import segexport
segexport.export('/path/to/output/file)
加载和运行
现在,加载导出的数据应该只是内存映射正确地址并从导出文件复制相应数据的问题。您可以在这里的load()函数中看到它。
但是,由于我们现在在用户空间中加载和运行内核代码,因此会有一些函数无法良好运行,或者我们希望更改。其中一个例子是内核分配器函数,我们希望用系统malloc替换它们。
替换这些函数的一种方法是重写我们想要替换的每个函数的prolog,使其跳转到其替换函数。但是,由于我们稍后将使用TinyInst来提取代码覆盖率,因此有一种更简单的方法。我们将简单地向每个要替换的函数写入一个断点指令。由于TinyInst(除其他外)是一个调试器,它将捕获每个断点,并且从TinyInst进程中,我们可以用相应替换函数的地址替换指令指针。更多细节可以在下一节中找到。
除了替换内存分配函数、日志记录函数等之外,我们还需要替换所有与我们无法从用户空间访问(或者在我们的情况下,甚至机器上不存在)的硬件交互的函数。在AppleAVD内核扩展中的AV1解析代码的情况下,会调用一个名为AppleAVD::sendCommandToCommandGate的函数,我假设这是为了与解码硬件通信。因此,作为harness的一部分,此函数被替换为始终返回0(成功)的函数。
AV1 harness代码的最终代码可以在这里找到。它可以编译为:
clang++ loader.cpp avdharness.cpp -oloader
并且可能需要一些额外的权限才能运行,可以使用以下命令应用:
codesign --entitlements entitlements.txt -f -s - ./loader
请注意,在harness代码中,尽管我尽可能尝试依赖符号名称而不是硬编码的偏移量,但它仍然包含一些结构体偏移量。此版本的harness基于macos 14.5内核,这是编写加载器时最新的操作系统版本。
编写自定义TinyInst模块
本节解释了伴随加载器的自定义TinyInst模块(并且是加载器正常运行所必需的)。此代码不包含任何特定于特定内核扩展的内容,因此可以按原样重用。如果您对它的工作原理或编写自定义TinyInst模块不感兴趣,那么可以跳过本节。
首先,由于我们希望提取代码覆盖率以用于fuzzing,我们将基于LiteCov(TinyInst的“默认”代码覆盖率模块)构建我们的自定义模块:
class AVDInst : public LiteCov {
…
};
其次,我们需要一种方式让我们的自定义加载器与TinyInst模块通信
- 它需要告诉TinyInst内核扩展中的哪些函数应该被哪些替换函数替换。
- 它需要告诉TinyInst内核扩展加载的位置,以便TinyInst可以检测它。
虽然TinyInst提供了一个用于函数hook的API,我们可以在这里使用,但也有一种更直接(尽管也更底层)的方式。从我们的加载器中,我们将简单地调用某个硬编码的非映射地址处的函数。这将再次导致TinyInst(作为调试器)捕获的异常,从寄存器读取参数,执行所需操作并“返回”(通过用链接寄存器中的值替换指令指针)。加载器使用硬编码地址0x747265706C616365来注册替换,使用0x747265706C616366来告诉TinyInst要检测的地址范围:
#define TINYINST_REGISTER_REPLACEMENT 0x747265706C616365
#define TINYINST_CUSTOM_INSTRUMENT 0x747265706C616366
我们可以在自定义模块的异常处理程序中捕获这些:
bool AVDInst::OnException(Exception *exception_record) {
…
if(exception_address == TINYINST_REGISTER_REPLACEMENT) {
RegisterReplacementHook();
return true;
}
if(exception_address == TINYINST_CUSTOM_INSTRUMENT) {
InstrumentCustomRange();
return true;
}
…
}
然后读取参数并执行所需操作:
void AVDInst::RegisterReplacementHook() {
uint64_t original_address = GetRegister(X0);
uint64_t replacement_address = GetRegister(X1);
redirects[original_address] = replacement_address;
SetRegister(ARCH_PC, GetRegister(LR));
}
void AVDInst::InstrumentCustomRange() {
uint64_t min_address = GetRegister(X0);
uint64_t max_address = GetRegister(X1);
InstrumentAddressRange("custom_range", min_address, max_address);
SetRegister(ARCH_PC, GetRegister(LR));
}
其中InstrumentAddressRange是最近添加的TinyInst函数,它将检测其参数中给出的地址之间的所有代码。“custom_range”只是我们给这个内存区域的名称,以便我们可以区分多个检测模块(如果有多个)。
接下来,TinyInst需要执行实际的函数替换。如上所述,这可以在我们模块的异常处理程序中完成。
auto iter = redirects.find(exception_address);
if(iter != redirects.end()) {
// printf("Redirecting...\n");
SetRegister(ARCH_PC, iter->second);
return true;
}
这对于在没有检测的情况下运行内核扩展(例如收集覆盖率)来说基本足够了。但是,如果我们还想检测扩展,那么检测过程涉及在另一个位置重写扩展代码,并插入例如记录覆盖率的附加指令。这样做的后果是,我们的断点指令(我们为了重定向而插入的)将在不同的地址被重写。我们需要让TinyInst意识到这一点(顺便说一下,TinyInst Hook API在底层执行此操作,但在此模块中未使用)。我们可以在InstrumentInstruction函数中执行此操作,该函数在检测每条指令时被调用:
InstructionResult AVDInst::InstrumentInstruction(ModuleInfo *module,
Instruction& inst,
size_t bb_address,
size_t instruction_address)
{
auto iter = redirects.find(instruction_address);
if(iter != redirects.end()) {
instrumented_redirects[assembler_->Breakpoint(module)] = iter->second;
return INST_STOPBB;
}
return LiteCov::InstrumentInstruction(module, inst, bb_address, instruction_address);
}
INST_STOPBB返回值告诉TinyInst停止处理当前基本块。由于在断点/重定向时,我们将执行重定向到另一个函数,因此同一基本块中的其他指令永远不会被执行,因此不需要。
在此之后,我们现在知道了检测代码和非检测代码中断点(以及相应的替换)的地址。我们自定义模块的最终异常处理程序如下所示:
bool AVDInst::OnException(Exception *exception_record) {
size_t exception_address;
if(exception_record->type == BREAKPOINT)
{
exception_address = (size_t)exception_record->ip;
} else if(exception_record->type == ACCESS_VIOLATION) {
exception_address = (size_t)exception_record->access_address;
} else {
return LiteCov::OnException(exception_record);
}
if(exception_address == TINYINST_REGISTER_REPLACEMENT) {
RegisterReplacementHook();
return true;
}
if(exception_address == TINYINST_CUSTOM_INSTRUMENT) {
InstrumentCustomRange();
return true;
}
auto iter = redirects.find(exception_address);
if(iter != redirects.end()) {
// printf("Redirecting...\n");
SetRegister(ARCH_PC, iter->second);
return true;
}
iter = instrumented_redirects.find(exception_address);
if(iter != instrumented_redirects.end()) {
// printf("Redirecting...\n");
SetRegister(ARCH_PC, iter->second);
return true;
}
return LiteCov::OnException(exception_record);
}
包含所有管理函数的完整代码可以在这里找到。
Fuzzing和发现
一旦我们的自定义模块准备就绪,我们仍然需要确保TinyInst和Jackalope将使用此模块而不是默认的LiteCov模块。请参阅TinyInst和Jackalope的相应补丁。
现在,我们的harness应该在TinyInst下正确运行,无论是否启用覆盖率检测:
./Jackalope/build/TinyInst/Release/litecov -- ./loader avd_rebased.dat -f
其中avd_rebased.dat包含从IDA导出的内核扩展代码。我们还可以添加-trace_basic_blocks标志来跟踪正在执行的基本块(主要用于调试)。我们还可以像这样运行Jackalope的fuzzing会话:
./Jackalope/build/Release/fuzzer -in in -out out -t 1000 -delivery shmem -target_module loader -target_method __Z4fuzzPc -nargs 1 -iterations 5000 -persist -loop -cmp_coverage -mute_child -nthreads 6 -- ./loader avd_rebased.dat -m @@
这告诉jackalope以持久模式运行(循环执行“fuzz”函数),通过共享内存传递样本(-delivery shmem fuzzer标志和-m在harness代码中实现)。
Fuzzing不仅有助于发现目标中的bug,在我们的案例中,还有助于发现harness中的bug,例如发现我们需要替换的其他内核函数,以便目标正常工作。
经过几次修复迭代后,harness似乎工作正常。然而,fuzzer也捕获了一些崩溃,这些崩溃似乎是由AV1解析代码中的真正问题引起的。我进行了根本原因分析,并将问题报告给了苹果。报告可以在Project Zero问题跟踪器的以下条目中看到:
- AppleAVD:AV1_Syntax::Parse_Header中的大型OBU大小导致越界读取
- AppleAVD:AV1_Syntax::f的问题导致越界读取
- AppleAVD:AV1_Syntax::Parse_Header中的整数下溢导致越界读取
不幸的是,在报告这些问题时,我仍然无法访问具有AV1解码功能的机器。因此,问题以完整根本原因分析和二进制流的形式报告,该流在用作特定解码函数的参数时会导致崩溃。最终,我们确实获得了一台支持AV1硬件解码的M3芯片Macbook,并尝试复现报告的问题。不出所料,所有三个问题在真实硬件上的复现与在用户空间harness中完全相同。
结论
该项目的目标是创建尽可能简单的用户空间内核扩展fuzzing工具,而简单性的原因之一至少是它可以轻松适应其他内核代码片段。这个过程足够通用,使我们能够fuzz通常需要硬件的AV1解析代码,而我们当时甚至没有该硬件。虽然在这项研究中发现的三个问题并不严重,但它们证明了该方法的正确性以及发现其他问题的潜力。