CVE-2021-30737,@xerub 发现的 2021 年 iOS ASN.1 漏洞
作者:Ian Beer,Google Project Zero
这篇博文是我对 @xerub 发现的一个漏洞的分析。Phrack 发布了 @xerub 的分析文章,请先查看那篇文章。
除了进行自己的漏洞研究外,我也花时间尽可能跟上公开的最新技术动态,尤其是在特别有趣的漏洞细节公布或新的野外利用被发现时。最初这篇文章只是我去年试图理解这个漏洞时做的一系列笔记。但这个漏洞本身及其背后的故事非常引人入胜,我认为值得将这些笔记整理成更连贯的形式与社区分享。
背景
2021年4月14日,《华盛顿邮报》发表了一篇关于 Azimuth 解锁圣贝纳迪诺 iPhone 的文章,其中包含了一条非公开信息:
"Azimuth 专门寻找重大漏洞。据知情人士透露,Dowd [...] 在 Mozilla 的开源代码中发现了一个漏洞,苹果使用该代码允许配件插入 iPhone 的 Lightning 端口。"
iPhone 上运行的 Mozilla 代码并不多,可能成为此类攻击面一部分的代码更少。因此,如果这个说法准确,几乎可以肯定 Azimuth 利用了 Security.framework 中使用的 ASN.1 解析器中的漏洞,该解析器是 Mozilla NSS ASN.1 解析器的一个分支。
我在 bugzilla(Mozilla 的问题跟踪器)中搜索了与《华盛顿邮报》文章中讨论的时间线匹配的候选漏洞,并将其缩小到几个可能的漏洞,包括:1202868、1192028、1245528。
我很惊讶 ASN.1 代码中竟然有这么多看起来可被利用的问题,并决定将审计 NSS ASN.1 解析器作为季度目标。
一个月后,正如预料的那样,我完全没有朝着这个目标做任何事,这时我看到了 @xerub 的这条推文:
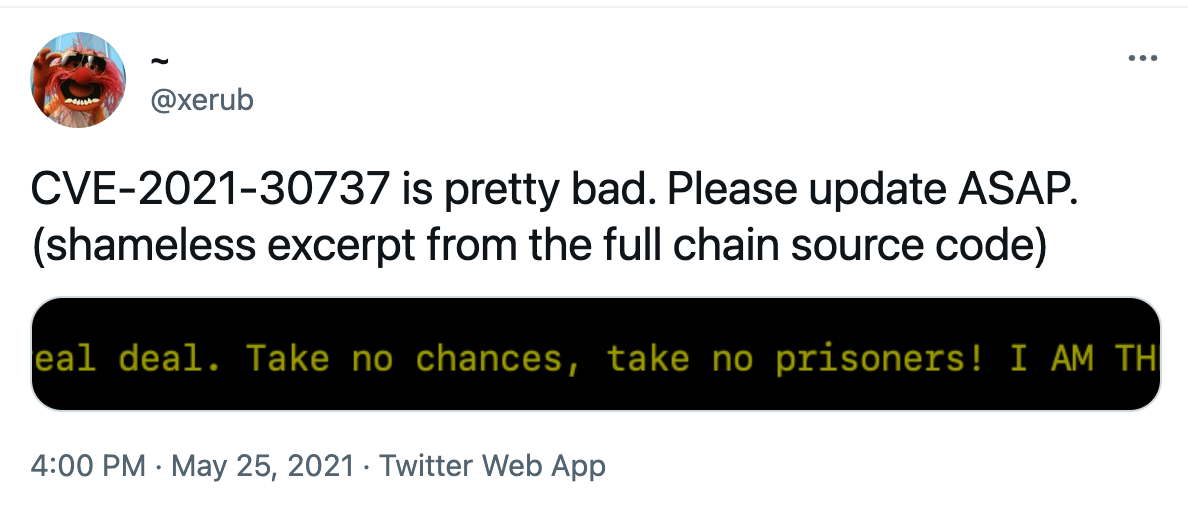
@xerub:CVE-2021-30737 相当严重。请尽快更新。(无耻摘录自完整链源代码)2021年5月25日下午4:00
无耻摘录内容如下:
// 这是真家伙。不要冒险,不要留情!我就是状态机!
而 CVE-2021-30737,在 iOS 14.6 中修复,在 iOS 发布说明 中描述为:
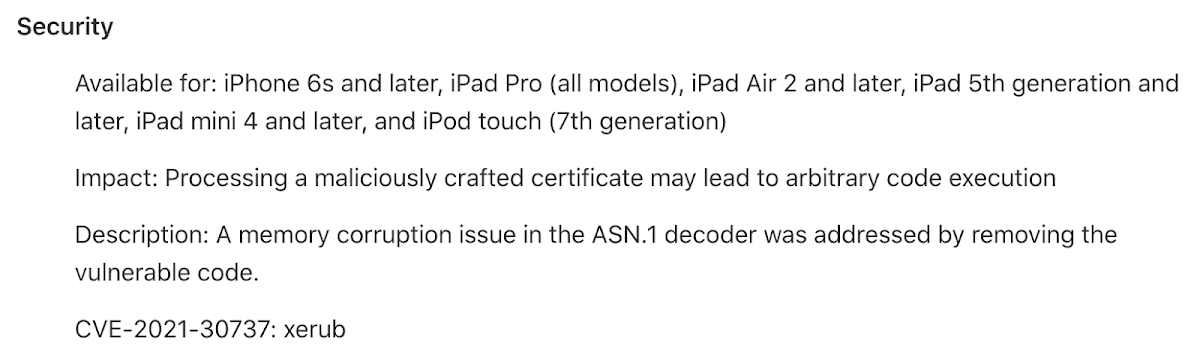
影响:处理恶意制作的证书可能导致任意代码执行
描述:通过移除易受攻击的代码,解决了 ASN.1 解码器中的内存损坏问题。
我有点懊恼自己没有凭直觉行动,因为那里显然隐藏着一些很棒的东西。我记下了一旦苹果发布源代码就进行 diff 比较,几周后他们终于在 opensource.apple.com 的 Security 包 中发布了。
以下是包含 ASN.1 解析器的 secasn1d.c 在 MacOS 11.4 和 11.3 版本之间的 diff:
diff --git a/OSX/libsecurity_asn1/lib/secasn1d.c b/OSX/libsecurity_asn1/lib/secasn1d.c
index f338527..5b4915a 100644
--- a/OSX/libsecurity_asn1/lib/secasn1d.c
+++ b/OSX/libsecurity_asn1/lib/secasn1d.c
@@ -434,9 +434,6 @@ loser:
PORT_ArenaRelease(cx->our_pool, state->our_mark);
state->our_mark = NULL;
}
- if (new_state != NULL) {
PORT_Free(new_state);- }
return NULL;
}
@@ -1794,19 +1791,13 @@ sec_asn1d_parse_bit_string (sec_asn1d_state *state,
/*PORT_Assert (state->pending > 0); */
PORT_Assert (state->place == beforeBitString);
- if ((state->pending == 0) || (state->contents_length == 1)) {
- if (state->pending == 0) {
if (state->dest != NULL) {
SecAsn1Item *item = (SecAsn1Item *)(state->dest);
item->Data = NULL;
item->Length = 0;
state->place = beforeEndOfContents;
}if(state->contents_length == 1) {/* skip over (unused) remainder byte */return 1;}else {return 0;
return 0;
}
}
第一个更改(移除 PORT_Free)对苹果的用例无关紧要,因为它修复了一个双重释放问题,但这不影响苹果的构建。这仅在启用"分配器标记"时相关,而此功能是禁用的。
因此,漏洞一定在 sec_asn1d_parse_bit_string 中。我们从 xerub 的推文中知道状态机出了问题,但要弄清楚这一点,我们需要了解一些 ASN.1 基础知识,然后开始研究 NSS ASN.1 状态机的工作原理。
ASN.1 编码
ASN.1 是一种类型-长度-值序列化格式,但它有一个巧妙的特性:它也可以处理你不知道值长度但仍想序列化的情况!这个特性只有在 ASN.1 按照基本编码规则(BER)编码时才可能实现。还有一种更严格的编码称为 DER(可辨别编码规则),它强制规定特定值只有一种正确的编码,并禁止在不知道最终长度的情况下序列化值的情况。
这个页面是 ASN.1 很好的入门指南。我强烈建议浏览一下以对 ASN.1 有一个很好的概述。
ASN.1 中有很多内置类型。我只描述理解此漏洞所需的最低限度(主要是因为我知道的也不多!)所以让我们从序列化 ASN.1 对象的第一个字节开始,弄清楚如何解码它:
第一个字节告诉你类型,最低的 5 位定义了类型标识符。特殊的类型标识符值 0x1f 告诉你类型标识符不适合这 5 位,而是以不同的方式编码(我们将忽略这一点):
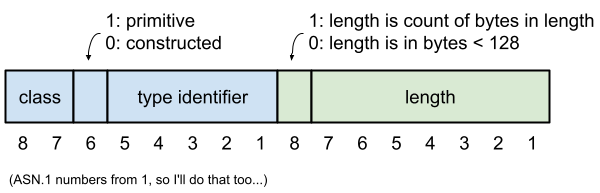
显示序列化 ASN.1 对象前两个字节的图表。本例中第一个字节是类型和类标识符,第二个是长度。
第一个字节的高两位告诉你类型的类别:通用、应用、内容特定或私有。对我们来说,我们将其保留为 0(通用)。
第 6 位是乐趣开始的地方。值为 1 告诉我们这是原始编码,这意味着长度后面是内容字节,可以直接解释为预期类型。例如,字符串"HELLO"作为 ASN.1 可打印字符串的原始编码将有一个长度为 5 的字节,后跟 ASCII 字符"HELLO"。这一切都相当简单。
然而,第 6 位的值为 0 告诉我们这是构造编码。这意味着长度后面的字节不是该类型的"原始"内容字节,而是一个或多个"块"的 ASN.1 编码,这些块需要单独解析并连接以形成最终输出值。为了让事情更加复杂,还可以指定长度值为 0,这意味着你甚至不知道重建的输出会有多长,或者需要多少后续输入来完全构建输出。
最后一种情况(具有不定长度的构造类型)称为不定形式。构成单个不定值的输入结束由一个序列化的类型信号表示,该类型的标识符、构造、类别和长度值都等于 0,编码为两个 NULL 字节。
ASN.1 位串
大多数 ASN.1 字符串类型不需要特殊处理;它们只是原始字节缓冲区。其中一些有长度限制。例如:BMP 字符串必须具有偶数长度,而 UNIVERSAL 字符串的长度必须是 4 字节的倍数,但仅此而已。
ASN.1 位串是比特串,而不是字节串。例如,你可以有一个长度为单个比特的位串(所以是 0 或 1),或者一个长度为 127 比特的位串(所以是 15 个完整字节加上额外的 7 比特)。
编码的 ASN.1 位串在长度之后、内容之前有一个额外的元数据字节,该字节编码最终字节中未使用的比特数。
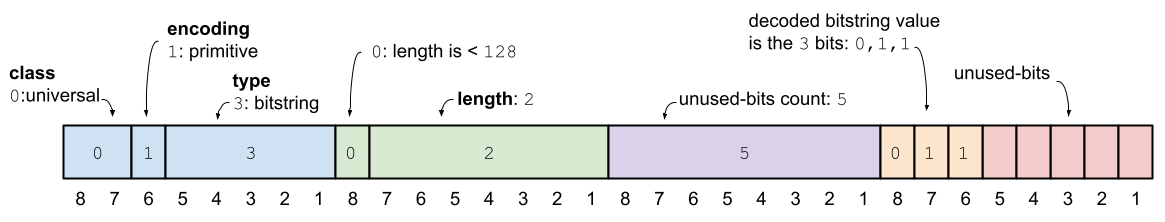
显示 3 比特位串完整编码的图表。长度为 2 包括未使用比特计数字节,其值为 5,表示只有最终字节的最高 3 位有效。
解析 ASN.1
ASN.1 数据总是需要与模板一起解码,模板告诉解析器期望什么数据,并提供输出指针以填充解析后的输出数据。以下是我的测试程序用于测试位串代码的模板:
const SecAsn1Template simple_bitstring_template[] = {
{
SEC_ASN1_BIT_STRING | SEC_ASN1_MAY_STREAM, // kind: bit string,
// may be constructed
0, // offset: in dest/src
NULL, // sub: subtemplate for indirection
sizeof(SecAsn1Item) // size: of output structure
}
};
SecASN1Item 是一个非常简单的缓冲区包装器。我们可以提供一个 SecAsn1Item 供解析器使用以返回解析后的位串,然后调用解析器:
SecAsn1Item decoded = {0};
PLArenaPool* pool = PORT_NewArena(1024);
SECStatus status =
SEC_ASN1Decode(pool, // pool: arena for destination allocations
&decoded, // dest: decoded encoded items in to here
&simple_bitstring_template, // template
asn1_bytes, // buf: asn1 input bytes
asn1_bytes_len); // len: input size
NSS ASN.1 状态机
状态机有两个核心数据结构:
SEC_ASN1DecoderContext - 整体解析上下文
sec_asn1d_state - 单个解析器状态,保存在双向链表中,形成嵌套状态的堆栈
以下是状态对象的精简版本,显示了相关字段:
typedef struct sec_asn1d_state_struct {
SEC_ASN1DecoderContext *top;
const SecAsn1Template *theTemplate;
void *dest;
struct sec_asn1d_state_struct *parent;
struct sec_asn1d_state_struct *child;
sec_asn1d_parse_place place;
unsigned long contents_length;
unsigned long pending;
unsigned long consumed;
int depth;
} sec_asn1d_state;
解析状态机的主要引擎是方法 SEC_ASN1DecoderUpdate,它接受一个上下文对象、原始输入缓冲区和长度:
SECStatus
SEC_ASN1DecoderUpdate (SEC_ASN1DecoderContext *cx,
const char *buf, size_t len)
当前状态存储在上下文对象的 current 字段中,该当前状态的 place 字段决定了解析器当前所处的状态。这些状态定义如下:
typedef enum {
beforeIdentifier,
duringIdentifier,
afterIdentifier,
beforeLength,
duringLength,
afterLength,
beforeBitString,
duringBitString,
duringConstructedString,
duringGroup,
duringLeaf,
duringSaveEncoding,
duringSequence,
afterConstructedString,
afterGroup,
afterExplicit,
afterImplicit,
afterInline,
afterPointer,
afterSaveEncoding,
beforeEndOfContents,
duringEndOfContents,
afterEndOfContents,
beforeChoice,
duringChoice,
afterChoice,
notInUse
} sec_asn1d_parse_place;
状态机循环根据 place 字段决定调用哪个方法:
switch (state->place) {
case beforeIdentifier:
consumed = sec_asn1d_parse_identifier (state, buf, len);
what = SEC_ASN1_Identifier;
break;
case duringIdentifier:
consumed = sec_asn1d_parse_more_identifier (state, buf, len);
what = SEC_ASN1_Identifier;
break;
case afterIdentifier:
sec_asn1d_confirm_identifier (state);
break;
...
每个可能消耗输入的状态方法都传递一个指针(buf)指向原始输入缓冲区中下一个未消耗的字节,以及剩余未消耗字节的计数(len)。
然后由这些方法中的每一个返回它们消耗了多少输入,并通过更新上下文对象的 status 字段来发出任何错误信号。
解析器可以是递归的:一个状态可以将其 ->place 字段设置为期望处理已解析子状态的状态,然后分配一个新的子状态。例如,在解析 ASN.1 序列时:
state->place = duringSequence;
state = sec_asn1d_push_state (state->top, state->theTemplate + 1,
state->dest, PR_TRUE);
当前状态将其自身的下一个状态设置为 duringSequence,然后调用 sec_asn1d_push_state,后者分配一个新的状态对象,具有新的模板和父状态 dest 字段的副本。
sec_asn1d_push_state 更新上下文的 current 字段,使得 SEC_ASN1DecoderUpdate 的下一次循环将看到这个子状态作为当前状态:
cx->current = new_state;
请注意,新分配的子状态的 place 字段(决定当前状态)的初始值由模板决定。然后,该子状态遵循的状态机路径的最终状态将负责将自己从状态堆栈中弹出,以便其父状态可以到达 duringSequence 状态以消耗子状态的结果。
缓冲区管理
缓冲区管理是 NSS ASN.1 解析器开始变得真正令人费解的地方。如果你通读代码,你会注意到在填充输出缓冲区时极度缺乏边界检查——基本上没有。例如,sec_asn1d_parse_leaf 只是简单地 memcpy 到输出缓冲区,没有边界检查来确保字符串的长度与缓冲区的大小匹配。
内存安全性不是通过显式的边界检查来确保长度有效,而是依赖于这样一个事实:解码有效的 ASN.1 永远不会产生比其输入更大的输出。
也就是说,没有解压缩或输入扩展的形式,因此任何解析后的输出数据的长度必须等于或短于编码它的输入。NSS 利用这一点,并将所有输出缓冲区过度分配为与其输入一样大。
对于原始字符串,这非常简单:提供了长度和输入,所以不会出什么大错。但对于构造字符串,这就有点棘手了……
思考构造字符串的一种方式是将其视为子字符串的树,嵌套深度可达 32 层。以下是一个示例:
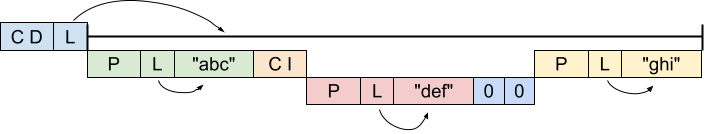
一个外部构造定长字符串,有三个子节点:一个原始字符串"abc"、一个构造不定长字符串和一个原始字符串"ghi"。构造不定长字符串有两个子节点,一个原始字符串"def"和一个内容结束标记。
我们从一个构造定长字符串开始。字符串的长度值 L 是构成此字符串的剩余输入的完整大小;该数量的输入字节应被解析为子字符串并连接以形成解析后的输出。
此时,NSS ASN.1 字符串解析器使用第一个输入字符串的长度 L 分配解析后输出字符串的输出缓冲区。这个缓冲区是过度分配的最坏情况。但真正有趣的部分是,NSS 分配输出缓冲区后,立即丢弃了那个长度!不过,快速浏览代码可能不太明显。分配的缓冲区存储为缓冲区包装器类型的 Data 字段:
typedef struct cssm_data {
size_t Length;
uint8_t * __nullable Data;
} SecAsn1Item, SecAsn1Oid;
(回想一下,我们在模板中传递了一个指向 SecAsn1Item 的指针;它的 Data 字段在这里被填充为分配的字符串缓冲区指针。这种类型在 NSS 和苹果的分支之间略有不同,但这里的差异无关紧要。)
那个 Length 字段不是分配的 Data 缓冲区的大小。它是一个(类型特定的)计数,决定了 Data 指向的缓冲区中有多少比特或字节是有效的。我说类型特定是因为对于位串,Length 以比特为单位存储,但对于其他字符串,它以字节为单位。(CVE-2016-1950 是 NSS 中的一个错误,代码混淆了这些单位。)
解析器没有存储分配的缓冲区大小以及缓冲区指针,而是每次遇到子字符串/子字符串时,都会走回当前正在解析的状态堆栈,以找到最内层的定长字符串。在向上遍历状态时,它会检查每个状态以确定它已经消耗了多少输入,以便能够确定当前待解析的子字符串是否确实完全包含在最内层的封闭定长字符串内。
如果这听起来很复杂,确实如此!执行此操作的逻辑在这里,我花了好几天时间才将其拆解开来,弄清楚这是在做什么:
sec_asn1d_state *parent = sec_asn1d_get_enclosing_construct(state);
while (parent && parent->indefinite) {
parent = sec_asn1d_get_enclosing_construct(parent);
}
unsigned long remaining = parent->pending;
parent = state;
do {
if (!sec_asn1d_check_and_subtract_length(&remaining,
parent->consumed,
state->top)
||
/* If parent->indefinite is true, parent->contents_length is
- zero and this is a no-op. */
!sec_asn1d_check_and_subtract_length(&remaining,
parent->contents_length,
state->top)
||
/* If parent->indefinite is true, then ensure there is enough
- space for an EOC tag of 2 bytes. */
( parent->indefinite
&&
!sec_asn1d_check_and_subtract_length(&remaining,
2,
state->top)
)
) {
/* This element is larger than its enclosing element, which is
- invalid. */
return;
}
} while ((parent = sec_asn1d_get_enclosing_construct(parent))
&&
parent->indefinite);
它首先向上遍历状态堆栈以找到最内层的构造定长状态,并使用其 state->pending 值作为上限。然后它再次遍历状态堆栈,并为每个中间状态从 pending 的原始值中减去这些中间状态可能消耗的字节数。很明显,pending 值因此至关重要;它用于确定上限,所以如果我们能搞乱它,这个"边界检查"可能会出错。
在弄清楚这显然是唯一进行任何边界检查的地方后,我更加仔细地查看了修复。
我们知道 sec_asn1d_parse_bit_string 是唯一更改的函数:
static unsigned long
sec_asn1d_parse_bit_string (sec_asn1d_state *state,
const char *buf, unsigned long len)
{
unsigned char byte;
/*PORT_Assert (state->pending > 0); */
PORT_Assert (state->place == beforeBitString);
if ((state->pending == 0) || (state->contents_length == 1)) {
if (state->dest != NULL) {
SecAsn1Item *item = (SecAsn1Item *)(state->dest);
item->Data = NULL;
item->Length = 0;
state->place = beforeEndOfContents;
}
if(state->contents_length == 1) {
/* skip over (unused) remainder byte */
return 1;
}
else {
return 0;
}
}
if (len == 0) {
state->top->status = needBytes;
return 0;
}
byte = (unsigned char) *buf;
if (byte > 7) {
dprintf("decodeError: parse_bit_string remainder oflow\n");
PORT_SetError (SEC_ERROR_BAD_DER);
state->top->status = decodeError;
return 0;
}
state->bit_string_unused_bits = byte;
state->place = duringBitString;
state->pending -= 1;
return 1;
}
函数的高亮区域是补丁移除的字符。这个函数旨在返回它消耗的输入字节数(由 buf 指向),我最初的直觉是注意到补丁移除了通过此函数的一条路径,在该路径中,你可能会使消耗的输入字节数和 pending 不同步。当它们在移除的代码中返回 1 时,它们也应该递减 state->pending,就像它们在此函数返回 1 的其他地方所做的那样。
我花了相当长的时间试图弄清楚如何将其转化为有用的东西,但最终我认为你做不到。
那么这里还发生了什么?
这个状态是在 buf 指向原始位串长度值之后的第一个字节时达到的。state->contents_length 是该解析长度的值。如前所述,位串是一种独特的 ASN.1 字符串类型,因为它们在开头有一个额外的元数据字节(未使用比特计数字节)。拥有一个定长的零长度字符串是完全没问题的——实际上,这(某种程度上)在 prepareForContents 状态中更早地处理了,该状态直接短路到 afterEndOfContents:
if (state->contents_length == 0 && (! state->indefinite)) {
/*
- A zero-length simple or constructed string; we are done.
*/
state->place = afterEndOfContents;
这里他们检测到一个内容长度为 0 的定长字符串类型。但这没有处理仅由未使用比特计数字节组成的位串的边缘情况。该位串的 state->contents_length 值将为 1,但它实际上没有任何"内容"。
正是这种情况与 sec_asn1d_parse_bit_string 中的 (state->contents_length == 1) 条件匹配:
if ((state->pending == 0) || (state->contents_length == 1)) {
if (state->dest != NULL) {
SecAsn1Item *item = (SecAsn1Item *)(state->dest);
item->Data = NULL;
item->Length = 0;
state->place = beforeEndOfContents;
}
if(state->contents_length == 1) {
/* skip over (unused) remainder byte */
return 1;
}
else {
return 0;
}
}
通过将 state->place 设置为 beforeEndOfContents,他们再次尝试短路状态机,跳过字符串内容被消耗后的状态。但在这里,他们采取了在 prepareForContents 中尝试实现完全相同目标时没有采取的额外步骤。除了更新 state->place 之外,他们还将 dest SecAsn1Item 的 Data 字段置为 NULL,并将 Length 设置为 0。
我之前提到过,为递归解析构造字符串的子字符串而分配的新子状态会获得父状态 dest 字段的副本(这是一个指向输出缓冲区的指针的指针)。这是有道理的:输出缓冲区只分配一次,然后由子状态以线性方式递归填充。(从技术上讲,如果最外层的字符串是不定长度的,这实际上不是它的工作方式,对于这种情况有单独的处理,而是构建一个子字符串的链表,最终连接起来,参见 sec_asn1d_concat_substrings。)
如果输出缓冲区只分配一次,那么如果你像他们在这里那样将 Data 设置为 NULL 会发生什么?退一步说,这到底有没有意义?
不,我认为这没有任何意义。此时将 Data 设置为 NULL 至少会导致内存泄漏,因为这是指向输出缓冲区的唯一指针。
但有趣的是,这并不是将该指针置为 NULL 的唯一后果。item->Data 用于表示其他东西。
以下是 prepare_for_contents 中的一个片段,当它确定输出缓冲区中是否有足够空间用于此子字符串时:
} else if (state->substring) {
/*
If we are a substring of a constructed string, then we may
not have to allocate anything (because our parent, the
actual constructed string, did it for us). If we are a
substring and we do have to allocate, that means our
parent is an indefinite-length, so we allocate from our pool;
later our parent will copy our string into the aggregated
whole and free our pool allocation.
*/
if (item->Data == NULL) {
PORT_Assert (item->Length == 0);
poolp = state->top->our_pool;
} else {
alloc_len = 0;
}
正如注释所暗示的,如果此时 item->Data 为 NULL 且 state->substring 为 true,那么(他们认为)一定 是这种情况:他们当前正在解析一个外层不定长字符串的子字符串,该字符串没有已分配的定长缓冲区。在这种情况下,item->Data 指针的含义与我们之前描述的不同:它只是一个临时缓冲区,仅用于保存此子字符串。就在这之前,alloc_len 被设置为此子字符串的内容长度;对于外层定长的情况,至关重要的是 alloc_len 然后在这里被设置为 0(这实际上表明缓冲区已经 分配,他们一定不能 分配新的缓冲区)。
为了强调可能微妙的一点:问题是使用这个组合(state->substring && !item->Data)来确定这是定长字符串的子字符串还是外层不定长字符串,与之前看到的复杂边界检查代码使用的方法不同。该方法向上遍历当前状态堆栈,并检查超字符串的 indefinite 位,以确定它们是否正在处理外层不定长字符串的子字符串。
把所有这些放在一起,你可能会明白这是怎么回事……(但这仍然相当微妙。)
假设我们有一个外层定长构造位串,包含三个原始位串作为子字符串:
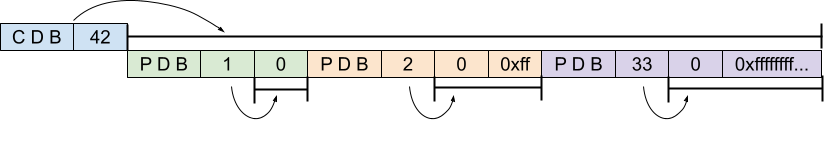
当遇到第一个最外层定长构造位串时,代码将分配一个固定大小的缓冲区,足够大以存储构成此字符串的所有剩余输入,在本例中为 42 字节。此时 dest->Data 指向该缓冲区。
然后他们分配一个子状态,该子状态获得 dest 指针的副本(不是 dest SecAsn1Item 对象的副本;是指向它的指针的副本),并继续解析第一个子字符串。
这是一个长度为 1 的原始位串,它触发了 sec_asn1d_parse_bit_string 中的易受攻击路径,并将 dest->Data 设置为 NULL。状态机跳转到 beforeEndOfContents,然后最终解析下一个子字符串——这次 dest->Data == NULL。
现在逻辑以糟糕的方式出错,正如我们在上面的片段中看到的,一个新的 dest->Data 缓冲区被分配,其大小仅为此子字符串(2 字节),而实际上 dest->Data 应该已经指向一个足够大以容纳整个外层不定长输入字符串的缓冲区。然后解析此位串的内容并将其复制到该缓冲区中。
现在我们来到第三个子字符串。dest->Data 不再为 NULL;但代码现在无法确定缓冲区实际上只(错误地)分配用于保存单个子字符串。它相信不变性:item->Data 只分配一次,当遇到第一个外层定长字符串时,并且它仅使用这一事实来确定 dest->Data 是否指向一个足够大的缓冲区以将此后子字符串附加到其中。然后它愉快地附加第三个子字符串,写入仅用于存储第二个子字符串的缓冲区边界之外。
这为你提供了一个很好的内存损坏原语:你可以导致分配一个受控大小的缓冲区,然后用任意数量的任意字节溢出它。
以下是触发此问题的 ASN.1 位串编码示例:
uint8_t concat_bitstrings_constructed_definite_with_zero_len_realloc[]
= {ASN1_CLASS_UNIVERSAL | ASN1_CONSTRUCTED | ASN1_BIT_STRING, // (0x23)
0x4a, // initial allocation size
ASN1_CLASS_UNIVERSAL | ASN1_PRIMITIVE | ASN1_BIT_STRING,
0x1, // force item->Data = NULL
0x0, // number of unused bits in the final byte
ASN1_CLASS_UNIVERSAL | ASN1_PRIMITIVE | ASN1_BIT_STRING,
0x2, // this is the reallocation size
0x0, // number of unused bits in the final byte
0xff, // only byte of bitstring
ASN1_CLASS_UNIVERSAL | ASN1_PRIMITIVE | ASN1_BIT_STRING,
0x41, // 64 actual bytes, plus the remainder, will cause 0x40 byte memcpy one byte in to 2 byte allocation
0x0, // number of unused bits in the final byte
0xff,
0xff,// -- continues for overflow
为什么 fuzzing 没有发现这个漏洞?
这是一个合理的问题。这段源代码真的很难审计,即使有 diff,也至少花了一周的工作才找出漏洞的真正根本原因。我不确定在代码审计期间我是否能发现这个问题。它非常有问题,但相当微妙,你必须了解很多关于状态机和边界检查规则才能看到它——我想我可能在弄清楚之前就放弃了,去找更容易的东西。
但触发测试用例在结构上既不复杂也不大,感觉 fuzzer 可以触及。那么为什么没有发现呢?我提出两点供讨论:
也许它没有被 fuzzing?
或者至少,它没有以出现在苹果 Security.framework 库中的确切形式被 fuzzing。我知道 Mozilla 和 Google 都对 NSS ASN.1 解析器进行了 fuzzing,并发现了一堆漏洞,但请注意,易受攻击代码的关键部分(sec_asn1d_parse_bit_string 中的"|| (state->contents_length == 1")在上游 NSS 中不存在(更多内容见下文)。
它能被有效地 fuzzing 吗?
即使你构建了 Security.framework 版本的代码并使用覆盖率引导的 fuzzer,你可能也不会触发任何崩溃。该代码使用自定义堆分配器,你必须要么用系统分配器的直接调用替换它,要么使用 ASAN 的自定义分配器钩子。请注意,上游 NSS 确实这样做,但据我所知,苹果的分支没有。
历史
我不仅对理解漏洞如何工作感兴趣,还对它是如何被引入的感兴趣。这个案例是一个特别引人注目的例子,因为一旦你理解了漏洞,代码结构最初看起来极其可疑。它只存在于苹果的 NSS 分支中,而该更改的唯一影响是引入了一个完美的内存损坏原语。但让我们回顾一下代码的历史,以说服自己这更可能只是一个不幸的事故:
我能找到的这段代码的最早引用是这个,它似乎是 2000 年 3 月 31 日 Mozilla CVS 仓库中的初始提交:
static unsigned long
sec_asn1d_parse_bit_string (sec_asn1d_state *state,
const char *buf, unsigned long len)
{
unsigned char byte;
PORT_Assert (state->pending > 0);
PORT_Assert (state->place == beforeBitString);
if (len == 0) {
state->top->status = needBytes;
return 0;
}
byte = (unsigned char) *buf;
if (byte > 7) {
PORT_SetError (SEC_ERROR_BAD_DER);
state->top->status = decodeError;
return 0;
}
state->bit_string_unused_bits = byte;
state->place = duringBitString;
state->pending -= 1;
return 1;
}
2001 年 8 月 24 日,代码的形式更改为类似于当前版本,在这个提交中带有消息"内存泄漏修复。":
static unsigned long
sec_asn1d_parse_bit_string (sec_asn1d_state *state,
const char *buf, unsigned long len)
{
unsigned char byte;
- PORT_Assert (state->pending > 0);
/*PORT_Assert (state->pending > 0); */
PORT_Assert (state->place == beforeBitString);
- if (state->pending == 0) {
if (state->dest != NULL) {SECItem *item = (SECItem *)(state->dest);item->data = NULL;item->len = 0;state->place = beforeEndOfContents;return 0;}- }
if (len == 0) {
state->top->status = needBytes;
return 0;
}
byte = (unsigned char) *buf;
if (byte > 7) {
PORT_SetError (SEC_ERROR_BAD_DER);
state->top->status = decodeError;
return 0;
}
state->bit_string_unused_bits = byte;
state->place = duringBitString;
state->pending -= 1;
return 1;
}
这个提交添加了 item->data = NULL 行,但在这里它仅在 pending == 0 时可到达。我相当确信这是死代码,实际上无法到达(并且他们注释掉的 PORT_Assert 实际上是有效的)。
beforeBitString 状态(导致调用 sec_asn1d_parse_bit_string 方法)将始终在 afterLength 状态(由 sec_asn1d_prepare_for_contents 实现)之前。在进入 afterLength 状态时,state->contents_length 等于解析的长度字段,而 sec_asn1d_prepare_for_contents 执行:
state->pending = state->contents_length;
因此,为了以 state->pending == 0 到达 sec_asn1d_parse_bit_string,state->contents_length 在 sec_asn1d_prepare_for_contents 中也必须为 0。
这意味着在下面的 if/else 决策树中,至少有一个条件必须为真:
if (state->contents_length == 0 && (! state->indefinite)) {
/*
- A zero-length simple or constructed string; we are done.
*/
state->place = afterEndOfContents;
...
} else if (state->indefinite) {
/*
- An indefinite-length string must be constructed!
*/
dprintf("decodeError: prepare for contents indefinite not construncted\n");
PORT_SetError (SEC_ERROR_BAD_DER);
state->top->status = decodeError;
但要求这两个条件都不为真,才能到达最终的 else,这是通过 beforeBitString 状态到达 sec_asn1d_parse_bit_string 的唯一路径:
} else {
/*
- A non-zero-length simple string.
*/
if (state->underlying_kind == SEC_ASN1_BIT_STRING)
state->place = beforeBitString;
else
state->place = duringLeaf;
}
因此,在那个时候(2001 年 8 月 24 日),NSS 代码库有一些死代码,看起来它试图处理解析没有未使用比特字节的 ASN.1 位串。正如我们在这篇文章的其余部分所看到的,这种处理方式非常错误,但这无关紧要,因为代码无法到达。
我能找到的苹果分支该 NSS 代码的最早引用是在 OS X 10.3(Panther)的 SecurityNssAsn1-11 包中,该版本于 2003 年 10 月 24 日发布。在该项目中,我们可以找到一个 CHANGES.apple 文件,它告诉我们更多关于苹果分支起源的信息:
一般说明
此模块 SecurityNssAsn1 基于 Mozilla 浏览器项目的 Netscape 安全服务("NSS")部分。SecurityNssAsn1 所基于的源代码是从 Mozilla CVS 仓库中提取的,截至 2003 年 1 月 21 日的最新版本。SecurityNssAsn1 项目仅包含 NSS 中用于执行 BER 编码和解码的部分,以及编码/解码例程所需的最小支持。
SecurityNssAsn1 的目录结构与 NSS 的目录结构有很大不同,使得简单的 diff 来记录更改变得笨拙。仍然可以逐个文件进行 diff。
所有苹果更改都通过符号 APPLE 标记,要么通过"#ifdef APPLE",要么在注释中。
该文档继续概述了苹果对代码进行的一系列广泛更改,包括重新格式化代码和更改许多 API 以添加新功能。我们还了解到苹果分支代码的日期(2003 年 1 月 21 日),因此我们可以通过 mozilla CVS 仓库的 github 镜像找到当时 secasn1d.c 的版本并进行 diff。
从那个 diff 中,我们可以看到苹果开发人员实际上在这个初始导入中进行了相当重大的更改,表明在导入之前,这段代码经过了一定程度的审查。例如:
@@ -1584,7 +1692,15 @@
/*
- If our child was just our end-of-contents octets, we are done.
*/
#ifdef __APPLE__/** Without the check for !child->indefinite, this path could* be taken erroneously if the child is indefinite!*/if(child->