一个伪造Carrier.app的离奇故事
作者:Ian Beer,Google Project Zero
注意:此问题 CVE-2021-30983 已于 2021 年 12 月在 iOS 15.2 中修复。
2021 年底,Google 的威胁分析小组(TAG)与我分享了一个 iPhone 应用:
应用启动画面显示沃达丰运营商徽标和文字“My Vodafone”(非官方沃达丰应用)
虽然这看起来像是 App Store 中真正的 My Vodafone 运营商应用,但它并非来自 App Store,也不是沃达福的官方应用。TAG 怀疑攻击者会先要求运营商禁用目标的移动数据连接,然后目标会收到一条包含此应用链接的短信。短信声称,为了恢复移动数据连接,目标必须安装该运营商应用,并包含一个下载和安装此假冒应用的链接。
这种旁加载之所以可行,是因为该应用使用了企业证书签名。该证书可以通过苹果的 企业开发者计划 以 299 美元购买。该计划允许符合条件的企业获取一个 Apple 签名的 embedded.mobileprovision 文件,其中设置了 ProvisionsAllDevices 键。使用该 mobileprovision 文件中嵌入的开发者证书签名的应用,可以旁加载到任何 iPhone 上,从而绕过苹果的 App Store 审核流程。虽然我们理解企业开发者计划旨在让公司向其员工的 iOS 设备推送“可信应用”,但在此案例中,它似乎被用于旁加载这个假冒的运营商应用。
Project Zero 与 TAG 合作发布了另一篇文章,提供了关于攻击目标和攻击者的更多细节。本文的其余部分将致力于对该应用及其包含的漏洞利用进行技术分析。
应用结构
该应用被拆分为多个框架。InjectionKit.framework 是一个通用的权限提升漏洞利用包装器,暴露了预期的原语(内核内存访问、权限注入、amfid 绕过)以及更高级的操作,如应用安装、文件创建等。
Agent.framework 部分经过混淆,但顾名思义,似乎是一个基本的代理程序,能够从设备上查找并外泄感兴趣的文件,如 WhatsApp 消息数据库。
该应用捆绑了六个权限提升漏洞利用。其中五个是针对旧版 iOS 的知名公开 N-day 漏洞利用。第六个则完全不同。
这篇博文讲述的是最后一个漏洞利用的故事,以及为理解它而进行的长达一个月的探索。
少了点什么?还是我漏掉了什么?
尽管所有漏洞利用都不同,但其中五个共享一个共同的高级结构。首先是操纵内核堆以控制对象布局的初始阶段。然后是触发内核漏洞,接着是通过众所周知的步骤将其转化为有用的东西,可能是通过泄露内核内存,然后构建任意内核内存写入原语。
第六个漏洞利用则完全没有这些内容。
也许它可能触发的是像 Linuz Henze 的 Fugu14 漏洞利用那样的内核逻辑漏洞,或者是一个非常严重的内存安全问题,能提供相当直接的内核内存访问。但这两者似乎都不太可能。简单来说,它看起来像是十年前的 iOS 内核漏洞利用,只不过它首先非常仔细地检查自己是否仅在 iPhone 12 或 13 上运行。
它包含如下日志消息:
printf("Failed to prepare fake vtable: 0x%08x", ret);
这似乎发生在漏洞利用可能已经绕过 KASLR 和 PAC 等缓解措施之前很久。
紧接着是这条日志消息:
printf("Waiting for R/W primitives...");
为什么需要等待?
然后不久之后:
printf("Memory read/write and callfunc primitives ready!");
到那时为止,漏洞利用只进行了四次 IOConnectCallMethod 调用,并且没有其他明显的堆操纵尝试。但还有另一条日志消息开始揭示一些线索:
printf("Unexpected data read from DCP: 0x%08x", v49);
DCP?
2021 年 10 月,Adam Donenfeld 发了这样一条推文:
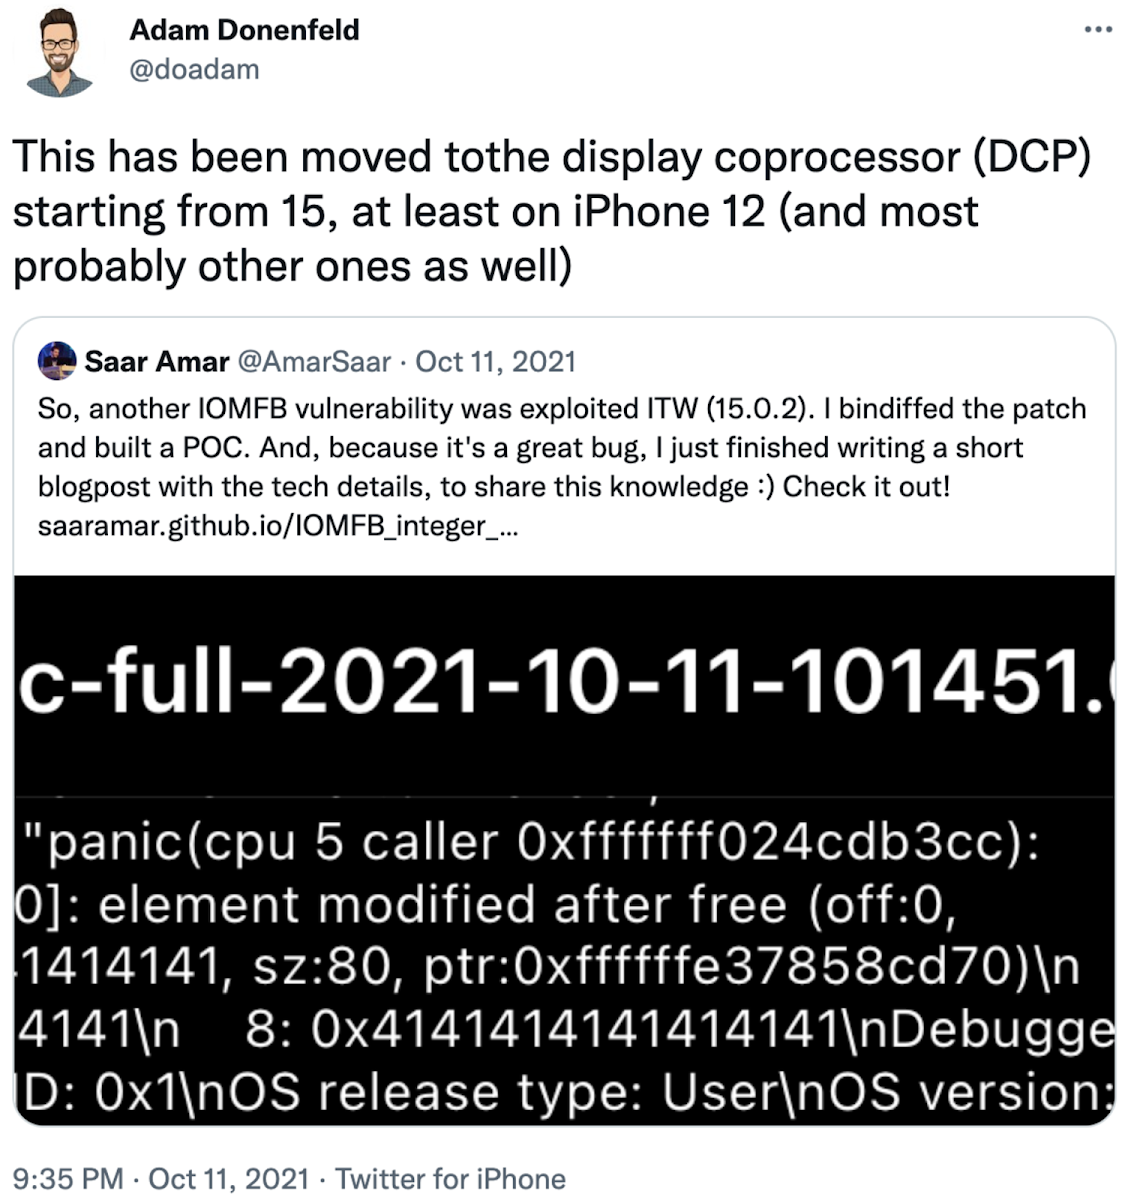
DCP 是“显示协处理器”,随 iPhone 12 及更高版本以及所有 M1 Mac 提供。
关于 DCP 的公开信息很少;最全面的信息来自 Asahi linux 项目,该项目正在将 linux 移植到 M1 Mac 上。在他们 2021年8月 和 2021年9月 的更新中,他们讨论了他们的 DCP 逆向工程工作以及由 @alyssarzg 编写的开源 DCP 客户端。Asahi 这样描述 DCP:
在大多数移动 SoC 上,显示控制器只是一个具有简单寄存器的硬件部件。虽然 M1 上也是如此,但苹果决定给它一个转折。他们给显示引擎添加了一个协处理器(称为 DCP),它运行自己的固件(由系统引导加载程序初始化),并将大部分显示驱动程序移到了协处理器中。但他们没有在自然的驱动程序边界上这样做……而是将 macOS C++ 驱动程序的一半移到了 DCP 中,并创建了一个远程过程调用接口,以便每一半都可以调用另一个 CPU 上 C++ 对象的方法!
https://asahilinux.org/2021/08/progress-report-august-2021/
Asahi linux 项目逆向工程了与 DCP 通信的 API,但他们仅限于使用苹果的 DCP 固件(由 iBoot 加载)——他们不能使用自定义的 DCP 固件。因此,他们的文档仅限于 DCP RPC API,几乎没有 DCP 内部细节。
背景铺垫
在深入探讨 DCP 内部之前,值得退一步思考。在现代高度集成的 SoC(片上系统)中,协处理器到底是什么?以及攻破它可能带来什么后果?
多年前,协处理器可能是一个物理上独立的芯片。如今,大量此类协处理器及其互连直接集成到单个芯片上,即使它们仍然是相当独立的系统。我们可以从 Tech Insights 的这张 M1 芯片照片中看到,中间和右侧的 CPU 核心仅占芯片面积的约 10%:
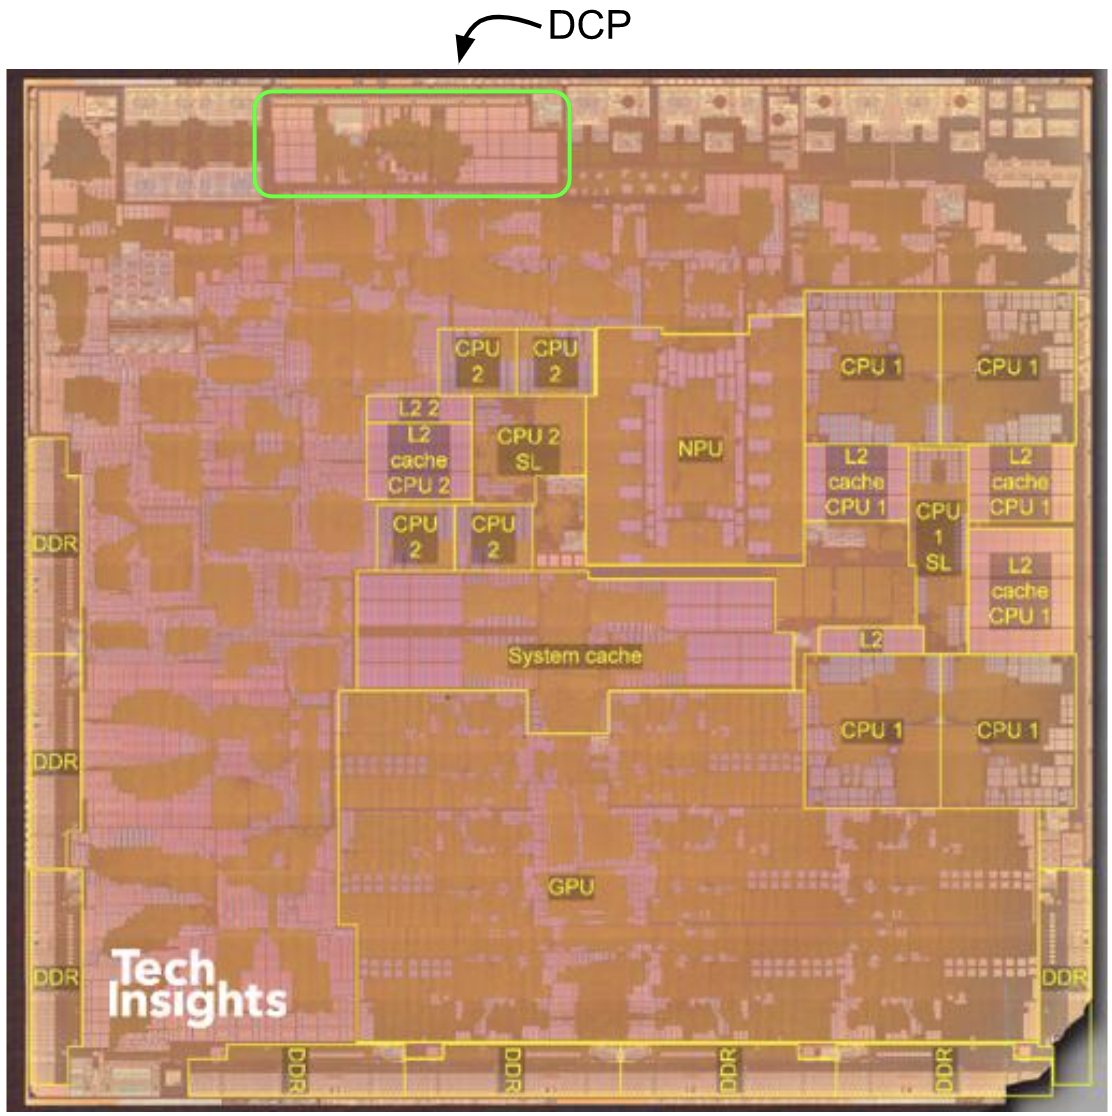
来自 techinsights.com 的 M1 芯片照片,添加了 DCP 的可能位置
https://www.techinsights.com/blog/two-new-apple-socs-two-market-events-apple-a14-and-m1
像 SystemPlus 这样的公司会对这些芯片进行 非常彻底的分析。根据他们的分析,DCP 很可能是这张 M1 芯片照片上指示的矩形区域。它占用的空间与中间看到的四个高效能核心大致相同,尽管它似乎主要是 SRAM。
仅凭这张低分辨率图像,我们无法对 DCP 的功能或能力以及它拥有何种级别的系统访问权限说更多。要回答这些问题,我们需要查看固件。
给我一个 .dSYM 文件,我可以给你一个王国!
第一步是获取 DCP 固件映像。iPhone(以及现在的 M1 Mac)使用 .ipsw 文件作为系统映像。.ipsw 实际上只是一个 .zip 压缩包,解压后的 .zip 中的 Firmware/ 文件夹包含所有协处理器、调制解调器等的固件。DCP 固件是这个文件:
Firmware/dcp/iphone13dcp.im4p
这里的 im4p 只是一个 25 字节的头部,我们可以丢弃它:
$ dd if=iphone13dcp.im4p of=iphone13dcp bs=25 skip=1
$ file iphone13dcp
iphone13dcp: Mach-O 64-bit preload executable arm64
它是一个 Mach-O 文件!运行 nm -a 列出所有符号,显示二进制文件已被完全剥离:
$ nm -a iphone13dcp
iphone13dcp: no symbols
函数名使理解代码变得容易得多。从查看漏洞利用中的少量字符串来看,其中一些似乎可能引用了 DCP 固件映像中的符号(例如“M3_CA_ResponseLUT read: 0x%08x”),所以我以为可能有一个 DCP 固件映像的符号没有被剥离。
由于固件映像以 .zip 文件形式分发,并且苹果的服务器支持范围请求,借助一点 Python 和 partialzip 工具,我们可以相对轻松快速地获取每个测试版和发布版的 DCP 固件。我检查了超过 300 个不同的映像;每一个都被剥离了。
看来我们得用困难的方式了!
第一天;第一条指令
$ otool -h raw_fw/iphone13dcp
raw_fw/iphone13dcp:
Mach header
      magic      cputype   cpusubtype caps filetype ncmds sizeofcmds flags
0xfeedfacf 0x100000C 0          0x00 5        5     2240       0x00000001
那个 cputype 是普通的 arm64(ArmV8),不支持指针身份验证。二进制文件相当大(3.7MB),IDA 的自动分析检测到超过 7000 个函数。
对于任何全新的二进制文件,我通常从简要浏览函数名和字符串开始。二进制文件被剥离,所以没有函数名符号,但有很多 C++ 函数名作为字符串:
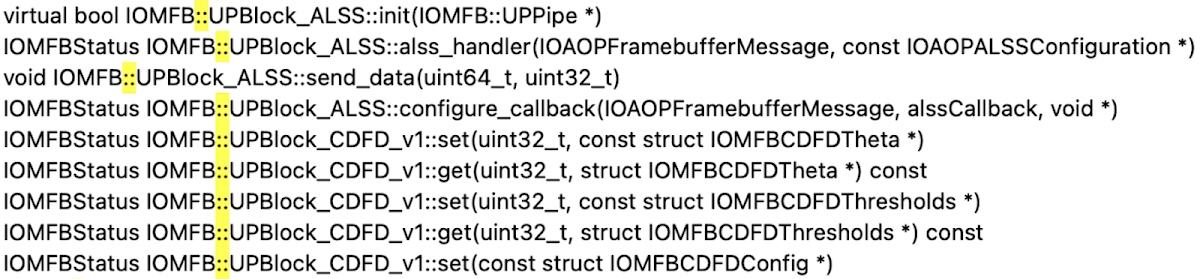
这些字符串的交叉引用看起来像这样:
log(0x40000001LL,
    "UPBlock_ALSS.cpp",
    341,
    "%s: capture buffer exhausted, aborting capture\n",
    "void IOMFB::UPBlock_ALSS::send_data(uint64_t, uint32_t)");
这几乎肯定是一个日志宏,它展开了 __FILE__、__LINE__ 和 __PRETTY_FUNCTION__。这使我们能够开始重命名函数并查找虚函数表指针。
对象结构
从 Asahi linux 的博文中我们知道,DCP 使用了一个名为 RTKit 的苹果专有 RTOS,关于它的公开信息非常少。二进制文件中有一些字符串包含确切的版本:
ADD  X8, X8, #aLocalIphone13d@PAGEOFF ; "local-iphone13dcp.release"
ADD  X9, X9, #aRtkitIos182640@PAGEOFF ; "RTKit_iOS-1826.40.9.debug"
代码似乎主要是 C++。似乎有多个 C++ 对象层次结构;与此漏洞相关的那些看起来有点像 IOKit C++ 对象。它们的公共基类看起来像这样:
struct __cppobj RTKIT_RC_RTTI_BASE
{
  RTKIT_RC_RTTI_BASE_vtbl *__vftable /*VFT*/;
  uint32_t refcnt;
  uint32_t typeid;
};
(这些结构定义采用 IDA 用于类 C++ 对象的格式)
RTKit 基类有一个虚函数表指针、一个引用计数和一个四字节的运行时类型信息(RTTI)字段——一个 4 字节的 ASCII 标识符,如 BLHA、WOLO、MMAP、UNPI、OSST、OSBO 等。这些标识符看起来有点神秘,但一旦你弄明白它们就很有描述性(我们会在遇到时描述相关的标识符。)
基类型有以下关联的虚函数表:
struct /*VFT*/ RTKIT_RC_RTTI_BASE_vtbl
{
  void (__cdecl *take_ref)(RTKIT_RC_RTTI_BASE *this);
  void (__cdecl *drop_ref)(RTKIT_RC_RTTI_BASE *this);
  void (__cdecl *take_global_type_ref)(RTKIT_RC_RTTI_BASE *this);
  void (__cdecl *drop_global_type_ref)(RTKIT_RC_RTTI_BASE *this);
  void (__cdecl *getClassName)(RTKIT_RC_RTTI_BASE *this);
  void (__cdecl *dtor_a)(RTKIT_RC_RTTI_BASE *this);
  void (__cdecl *unk)(RTKIT_RC_RTTI_BASE *this);
};
漏洞利用流程
应用中运行的漏洞利用首先打开 AppleCLCD2 服务的 IOKit 用户客户端。AppleCLCD 似乎是 IOMobileFrameBuffer 的应用处理器版本,而 AppleCLCD2 是 DCP 版本。
漏洞利用只调用了 AppleCLCD2 用户客户端上的 3 个不同的外部方法选择器:68、78 和 79。
输入最大且看起来最有趣的是 78,它对应于内核驱动程序中的这个用户客户端方法:
IOReturn
IOMobileFramebufferUserClient::s_set_block(
        IOMobileFramebufferUserClient *this,
        void *reference,
        IOExternalMethodArguments *args)
{
  const unsigned __int64 *extra_args;
  u8 *structureInput;

  structureInput = args->structureInput;
  if ( structureInput && args->scalarInputCount >= 2 )
  {
    if ( args->scalarInputCount == 2 )
      extra_args = 0LL;
    else
      extra_args = args->scalarInput + 2;
    return this->framebuffer_ap->set_block_dcp(
             this->task,
             args->scalarInput[0],
             args->scalarInput[1],
             extra_args,
             args->scalarInputCount - 2,
             structureInput,
             args->structureInputSize);
  } else {
    return 0xE00002C2;
  }
}
这个方法解包 IOConnectCallMethod 参数并将它们传递给:
IOMobileFramebufferAP::set_block_dcp(
        IOMobileFramebufferAP *this,
        task *task,
        int first_scalar_input,
        int second_scalar_input,
        const unsigned __int64 *pointer_to_remaining_scalar_inputs,
        unsigned int scalar_input_count_minus_2,
        const unsigned __int8 *struct_input,
        unsigned __int64 struct_input_size)
这个方法使用一些自动生成的代码将外部方法参数序列化到如下缓冲区中:
arg_struct:
{
  struct task* task
  u64 scalar_input_0
  u64 scalar_input_1
  u64[] remaining_scalar_inputs
  u64 cntExtraScalars
  u8[] structInput
  u64 CntStructInput
}
然后将其传递给 UnifiedPipeline2::rpc,同时传递一个 4 字节的 ASCII 方法标识符(这里是 'A435'):
UnifiedPipeline2::rpc(
        'A435',
        arg_struct,
        0x105Cu,
        &retval_buf,
        4u);
UnifiedPipeline2::rpc 调用 DCPLink::rpc,后者调用 AppleDCPLinkService::rpc 进行另一级序列化,将方法标识符和“流标识符”与上面显示的 arg_struct 打包在一起。
然后 AppleDCPLinkService::rpc 调用 rpc_caller_gated 在共享内存缓冲区中分配空间,将缓冲区复制到那里,然后向 DCP 发出信号,表明有消息可用。
实际上,IOMobileFramebuffer 用户客户端的实现已经移到了 DCP 上,外部方法接口现在是通过共享内存到 DCP 上运行的外部方法实际实现的代理垫片。
漏洞利用流程:另一端
下一个挑战是找到消息在 DCP 上开始处理的位置。查看日志字符串,有一个函数显然名为 rpc_callee_gated——很可能这是我们之前看到的函数 rpc_caller_gated 的接收端。
rpc_callee_gated 解包线路格式,然后有一个巨大的 switch 语句,将所有 4 字母 RPC 代码映射到函数指针:
switch ( rpc_id )
{
  case 'A000':
    goto LABEL_146;
  case 'A001':
    handler_fptr = callback_handler_A001;
    break;
  case 'A002':
    handler_fptr = callback_handler_A002;
    break;
  case 'A003':
    handler_fptr = callback_handler_A003;
    break;
  case 'A004':
    handler_fptr = callback_handler_A004;
    break;
  case 'A005':
    handler_fptr = callback_handler_A005;
    break;
在这个 switch 语句的底部是回调处理程序的调用:
ret = handler_fptr(
        meta,
        in_struct_ptr,
        in_struct_size,
        out_struct_ptr,
        out_struct_size);
in_struct_ptr 指向我们之前在应用处理器上看到的序列化的 IOConnectCallMethod 参数的副本:
arg_struct:
{
  struct task* task
  u64 scalar_input_0
  u64 scalar_input_1
  u64[] remaining_scalar_inputs
  u32 cntExtraScalars
  u8[] structInput
  u64 cntStructInput
}
回调解包该缓冲区并调用一个 C++ 虚函数:
unsigned int
callback_handler_A435(
        u8* meta,
        void *args,
        uint32_t args_size,
        void *out_struct_ptr,
        uint32_t out_struct_size
{
  int64 instance_id;
  uint64_t instance;
  int err;
  int retval;
  unsigned int result;

  instance_id = meta->instance_id;
  instance =
    global_instance_table[instance_id].IOMobileFramebufferType;
  if ( !instance ) {
    log_fatal(
      "IOMFB: %s: no instance for instance ID: %u\n",
      "static T *IOMFB::InstanceTracker::instance"
      "(IOMFB::InstanceTracker::tracked_entity_t, uint32_t)"
      " [T = IOMobileFramebuffer]",
      instance_id);
  }

  err = (instance-16)->vtable_0x378(  // virtual call
          (instance-16),
          args->task,
          args->scalar_input_0,
          args->scalar_input_1,
          args->remaining_scalar_inputs,
          args->cntExtraScalars,
          args->structInput,
          args->cntStructInput);
  retval = convert_error(err);
  result = 0;
  *(_DWORD *)out_struct_ptr = retval;
  return result;
}
这里的挑战是弄清楚那个虚调用指向哪里。对象基于实例 ID 在全局表中查找。我们不能只是设置断点,虽然模拟固件可能可行,但这本身可能是一个漫长的项目。我采用了一种更取巧的方法:我们知道虚函数表至少需要 0x380 字节大,所以只需遍历所有这些虚函数表,反编译它们,看看原型是否看起来合理!
在 UNPI 类型的虚函数表中有一个明显的匹配:
UNPI::set_block(
        UNPI* this,
        struct task* caller_task_ptr,
        unsigned int first_scalar_input,
        int second_scalar_input,
        int *remaining_scalar_inputs,
        uint32_t cnt_remaining_scalar_inputs,
        uint8_t *structure_input_buffer,
        uint64_t structure_input_size)
以下是我逆向的 UNPI::set_block 实现:
UNPI::set_block(
        UNPI* this,
        struct task* caller_task_ptr,
        unsigned int first_scalar_input,
        int second_scalar_input,
        int *remaining_scalar_inputs,
        uint32_t cnt_remaining_scalar_inputs,
        uint8_t *structure_input_buffer,
        uint64_t structure_input_size)
{
  struct block_handler_holder *holder;
  struct metadispatcher metadisp;

  if ( second_scalar_input )
    return 0x80000001LL;

  holder = this->UPPipeDCP_H13P->block_handler_holders;
  if ( !holder )
    return 0x8000000BLL;

  metadisp.address_of_some_zerofill_static_buffer = &unk_3B8D18;
  metadisp.handlers_holder = holder;
  metadisp.structure_input_buffer = structure_input_buffer;
  metadisp.structure_input_size = structure_input_size;
  metadisp.remaining_scalar_inputs = remaining_scalar_inputs;
  metadisp.cnt_remaining_sclar_input = cnt_remaining_scalar_inputs;
  metadisp.some_flags = 0x40000000LL;
  metadisp.dispatcher_fptr = a_dispatcher;
  metadisp.offset_of_something_which_looks_serialization_related = &off_1C1308;
  return metadispatch(holder, first_scalar_input, 1, caller_task_ptr, structure_input_buffer, &metadisp, 0);
}
这个方法将参数包装到另一个我称之为 metadispatcher 的结构中:
struct __attribute__((aligned(8))) metadispatcher
{
  uint64_t address_of_some_zerofill_static_buffer;
  uint64_t some_flags;
  __int64 (__fastcall *dispatcher_fptr)(struct metadispatcher *, struct BlockHandler *, __int64, _QWORD);
  uint64_t offset_of_something_which_looks_serialization_related;
  struct block_handler_holder *handlers_holder;
  uint64_t structure_input_buffer;
  uint64_t structure_input_size;
  uint64_t remaining_scalar_inputs;
  uint32_t cnt_remaining_sclar_input;
};
然后该 metadispatcher 对象被传递给这个方法:
return metadispatch(holder, first_scalar_input, 1, caller_task_ptr, structure_input_buffer, &metadisp, 0);
在那里我们到达这段代码:
block_type_handler = lookup_a_handler_for_block_type_and_subtype(
        a1,
        first_scalar_input, // block_type
        a3);                // subtype
漏洞利用两次调用这个 set_block 外部方法,为 first_scalar_input 传递两个不同的值:7 和 19。在这里我们可以看到,它们对应于在此处查找两个不同的块处理程序对象。
查找函数搜索块处理程序结构的链表;链表的头部存储在 UPPipeDCP_H13P 对象的偏移 0x1448 处,并由我命名为 add_handler_for_block_type 的方法动态注册:
add_handler_for_block_type(struct block_handler_holder *handler_list,
                           struct BlockHandler *handler)
日志代码告诉我们,这在一个名为 IOMFBBlockManager.cpp 的文件中。IDA 找到了此方法的 44 个交叉引用,表明可能有很多不同的块处理程序。每个注册的块处理程序的结构大致如下:
struct __cppobj BlockHandler : RTKIT_RC_RTTI_BASE
{
  uint64_t field_16;
  struct handler_inner_types_entry *inner_types_array;
  uint32_t n_inner_types_array_entries;
  uint32_t field_36;
  uint8_t can_run_without_commandgate;
  uint32_t block_type;
  uint64_t list_link;
  uint64_t list_other_link;
  uint32_t some_other_type_field;
  uint32_t some_other_type_field2;
  uint32_t expected_structure_io_size;
  uint32_t field_76;
  uint64_t getBlock_Impl;
  uint64_t setBlock_Impl;
  uint64_t field_96;
  uint64_t back_ptr_to_UPPipeDCP_H13P;
};
RTTI 类型是 BLHA(块处理程序)。
例如,以下是构建和注册块处理程序类型 24 的代码路径:
BLHA_24 = (struct BlockHandler *)CXXnew(112LL);
BLHA_24->__vftable = (BlockHandler_vtbl *)BLHA_super_vtable;
BLHA_24->block_type = 24;
BLHA_24->refcnt = 1;
BLHA_24->can_run_without_commandgate = 0;
BLHA_24->some_other_type_field = 0LL;
BLHA_24->expected_structure_io_size = 0xD20;
typeid = typeid_BLHA();
BLHA_24->typeid = typeid;
modify_typeid_ref(typeid, 1);
BLHA_24->__vftable = vtable_BLHA_subclass_type_24;
BLHA_24->inner_types_array = 0LL;
BLHA_24->n_inner_types_array_entries = 0;
BLHA_24->getBlock_Impl = BLHA_24_getBlock_Impl;
BLHA_24->setBlock_Impl = BLHA_24_setBlock_Impl;
BLHA_24->field_96 = 0LL;
BLHA_24->back_ptr_to_UPPipeDCP_H13P = a1;
add_handler_for_block_type(list_holder, BLHA_24);
每个块处理程序可选地具有 getBlock_Impl 和 setBlock_Impl 函数指针,它们似乎实现了实际的设置和获取操作。
我们可以遍历所有添加块处理程序的调用点;告诉 IDA 参数的类型,并命名所有的 getBlock 和 setBlock 实现:
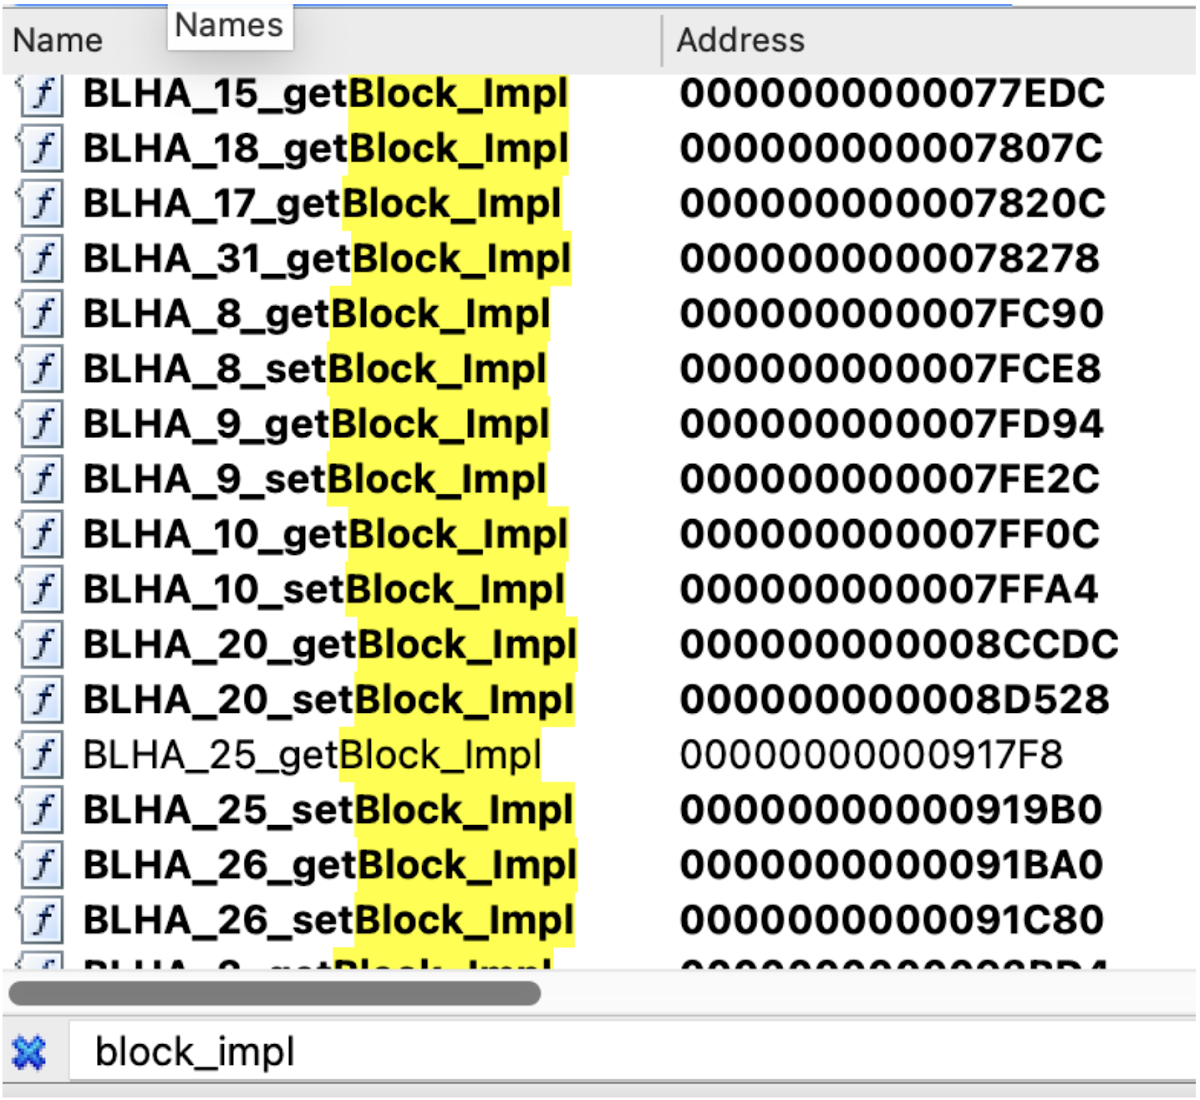
你或许能看出这走向何方:这看起来像是非常多的可攻击面!每个 setBlock_Impl 函数都可以通过向 IOConnectCallMethod 78 传递不同的第一个标量参数值来访问。
不过,还需要进行一点逆向工程来弄清楚如何精确地将受控字节传递到那些 setBlock_Impl 函数:
内存映射
每个 setBlock_Impl 方法的原始“块”输入并不是以内联方式在 IOConnectCallMethod 的结构输入中传递的。还有另一层间接性:每个单独的块处理程序结构都有一个支持的“子类型”数组,其中包含元数据,详细说明从 IOConnectCallMethod 结构输入的哪个偏移量查找该子类型输入数据的(用户空间)指针。结构输入中的第一个双字是此子类型的 ID——在这种情况下,对于块处理程序类型 19,元数据数组有一个条目:
<2, 0, 0x5F8, 0x600>
第一个值(2)是子类型 ID,0x5f8 和 0x600 告诉 DCP 从结构输入数据的哪个偏移量读取指针和大小。然后 DCP 从调用任务向 AP 请求该内存的映射:
return wrap_MemoryDescriptor::withAddressRange(
         *(void*)(structure_input_buffer + addr_offset),
         *(unsigned int *)(structure_input_buffer + size_offset),
         caller_task_ptr);
我们之前看到 AP 向 DCP 发送了调用任务的 struct task 指针;当 DCP 从用户任务请求内存映射时,它会将这些原始任务结构指针发送回 AP,以便内核可以从正确的任务执行映射。内存映射在 DCP 端被抽象为 MDES 对象;映射的实现涉及 DCP 向 AP 发起 RPC:
make_link_call('D453', &req, 0x20, &resp, 0x14);
这对应于 AP 端对此方法的调用:
IOMFB::MemDescRelay::withAddressRange(unsigned long long, unsigned long long, unsigned int, task*, unsigned long*, unsigned long long*)
DCP 在返回的 MDES 对象上调用 ::prepare 和 ::map(就像 IOKit 中的 IOMemoryDescriptor 对象一样),获取映射的指针和大小,通过最后几层间接性传递给块处理程序:
a_descriptor_with_controlled_stuff->dispatcher_fptr(
  a_descriptor_with_controlled_stuff,
  block_type_handler,
  important_ptr,
  important_size);
其中 dispatcher_fptr 看起来像这样:
a_dispatcher(
        struct metadispatcher *disp,
        struct BlockHandler *block_handler,
        __int64 controlled_ptr,
        unsigned int controlled_size)
{
  return block_handler->BlockHandler_setBlock(
           block_handler,
           disp->structure_input_buffer,
           disp->structure_input_size,
           disp->remaining_scalar_inputs,
           disp->cnt_remaining_sclar_input,
           disp->handlers_holder->gate,
           controlled_ptr,
           controlled_size);
}
你可以看到,在逆向过程中不断创建结构定义是多么有用;有如此多的间接层,几乎不可能把所有东西都记在脑子里。
BlockHandler_setBlock 是 BLHA 上的一个虚方法。这是 BLHA 19 的实现:
BlockHandler19::setBlock(
        struct BlockHandler *this,
        void *structure_input_buffer,
        int64 structure_input_size,
        int64 *remaining_scalar_inputs,
        unsigned int cnt_remaining_scalar_inputs,
        struct CommandGate *gate,
        void* mapped_mdesc_ptr,
        unsigned int mapped_mdesc_length)
这使用了一个命令门(GATI)对象(类似于 IOKit 中的调用门来序列化调用)来最终接近实际调用 setBlock_Impl 函数。
我们需要逆向 gate_context 结构来跟踪受控数据通过门的过程:
struct __attribute__((aligned(8))) gate_context
{
  struct BlockHandler *the_target_this;
  uint64_t structure_input_buffer;
  void *remaining_scalar_inputs;
  uint32_t cnt_remaining_scalar_inputs;
  uint32_t field_28;
  uint64_t controlled_ptr;
  uint32_t controlled_length;
};
调用门对象使用该上下文对象最终调用 BLHA setBlock 处理程序:
callback_used_by_callgate_in_block_19_setBlock(
        struct UnifiedPipeline *parent_pipeline,
        struct gate_context *context,
        int64 a3,
        int64 a4,
        int64 a5)
{
  return context->the_target_this->setBlock_Impl)(
           context->the_target_this->back_ptr_to_UPPipeDCP_H13P,
           context->structure_input_buffer,
           context->remaining_scalar_inputs,
           context->cnt_remaining_scalar_inputs,
           context->controlled_ptr,
           context->controlled_length);
}
SetBlock_Impl
最终,我们完成了整个调用栈的跟踪,从 AP 上用户空间的 IOConnectCallMethod 中的受控数据,一直到 DCP 上的 setBlock_Impl 方法!
setBlock_Impl 方法的原型如下所示:
setBlock_Impl(struct UPPipeDCP_H13P *pipe_parent,
              void *structure_input_buffer,
              int *remaining_scalar_inputs,
              int cnt_remaining_scalar_inputs,
              void* ptr_via_memdesc,
              unsigned int len_of_memdesc_mapped_buf)
漏洞利用调用了两个 setBlock_Impl 方法:7 和 19。7 相当简单,似乎仅用于将受控数据放在已知位置。19 是有漏洞的那个。从日志字符串中我们可以看出,块类型 19 处理程序在一个名为 UniformityCompensator.cpp 的文件中实现。
均匀性补偿 是一种校正显示面板上亮度和色彩再现不一致性的方法。块类型 19 设置和获取包含此校正信息的数据结构。setBlock_Impl 方法调用 UniformityCompensator::set 并到达以下代码片段,其中 controlled_size 是从结构输入中读取的完全受控的 u32 值,而 indirect_buffer_ptr 指向映射的缓冲区,其内容也受控:
uint8_t* pages = compensator->inline_buffer; // +0x24
for (int pg_cnt = 0; pg_cnt < 3; pg_cnt++) {
  uint8_t* this_page = pages;
  for (int i = 0; i < controlled_size; i++) {
    memcpy(this_page, indirect_buffer_ptr, 4 * controlled_size);
    indirect_buffer_ptr += 4 * controlled_size;
    this_page += 0x100;
  }
  pages += 0x4000;
}
这里明显缺乏对 controlled_size 的边界检查。根据代码结构,它应该被限制为小于或等于 64(因为这将导致输入被完全复制到输出缓冲区。)compensator->inline_buffer 缓冲区内联在补偿器对象中。代码结构表明该缓冲区可能为 0xc000(三个 16k 页)大小。为了验证这一点,我们需要找到这个补偿器对象的分配位置。
它是从 pipe_parent 对象中读取的,并且我们知道此时 pipe_parent 是一个 UPPipeDCP_H13P 对象。
对该字段只有一次写入,在 UPPipeDCP_H13P::setup_tunables_base_target 中:
compensator = CXXnew(0xC608LL);
...
this->compensator = compensator;
补偿器对象是一个 0xc608 字节的分配;0xc000 大小的缓冲区从偏移 0x24 开始,因此分配有足够的空间,在损坏相邻对象之前有 0xc608-0x24=0xC5E4 字节。
漏洞利用为块处理程序 19 setBlock 调用提供的结构输入如下所示:
struct_input_for_block_handler_19[0x5F4] = 70; // controlled_size
struct_input_for_block_handler_19[0x5F8] = address;
struct_input_for_block_handler_19[0x600] = a_size;
这导致在前面显示的 UniformityCompensator::set 片段中 controlled_size 的值为 70(0x46)。(0x5f8 和 0x600 对应于我们之前在子类型表中看到的偏移量:<2, 0, 0x5F8, 0x600>)
内层循环每次迭代将目标指针增加 0x100,因此 0x46 次循环迭代将写入 0x4618 字节。
外层循环写入三个连续的 0x4000 字节块,因此第三次(最后一次)迭代从 0x24 + 0x8000 开始写入,总共写入 0x4618 字节,这意味着对象需要是 0xC63C 字节;但我们可以看到它只有 0xc608,这意味着它将溢出分配大小 0x34 字节。RTKit 的 malloc 实现看起来为每个分配添加了 8 字节的元数据,因此下一个对象从 0xc610 开始。
消耗了多少输入?输入被完全消耗,没有“回退”,所以是 30x460x46*4 = 0xe5b0 字节。从该缓冲区的末尾倒推,我们知道其最后 0x34 字节超出了 0xc608 分配的范围,这意味着输入缓冲区中的 +0xe57c 将是损坏 8 字节元数据的第一个字节,而 +0x8584 将是损坏下一个对象的第一个字节:
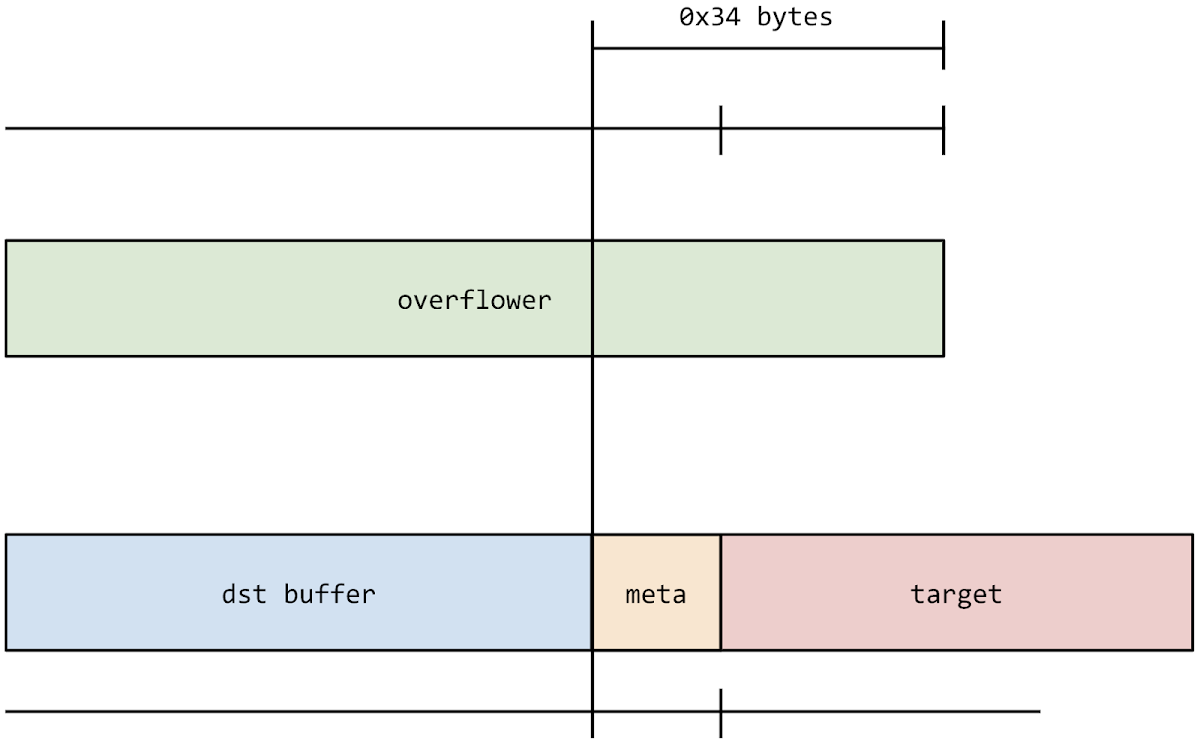
这与漏洞利用构建的溢出对象完全吻合:
v24 = address + 0xE584;
v25 = *(_DWORD *)&v54[48];
v26 = *(_OWORD *)&v54[32];
v27 = *(_OWORD *)&v54[16];
*(_OWORD *)(address + 0xE584) = *(_OWORD *)v54;
*(_OWORD *)(v24 + 16) = v27;
*(_OWORD *)(v24 + 32) = v26;
*(_DWORD *)(v24 + 48) = v25;
目标对象似乎分配得非常早,并且 DCP RTKit 环境似乎非常确定,没有 ASLR。几乎可以肯定,他们试图用一个假的虚函数表指针来损坏相邻的 C++ 对象。
不幸的是,对于我们的分析,线索在这里中断了,我们无法完全重现漏洞利用的其余部分。假 DCP C++ 对象的字节是从应用临时目录中的一个文件中读取的(base64 编码在 JSON 文件中,位于